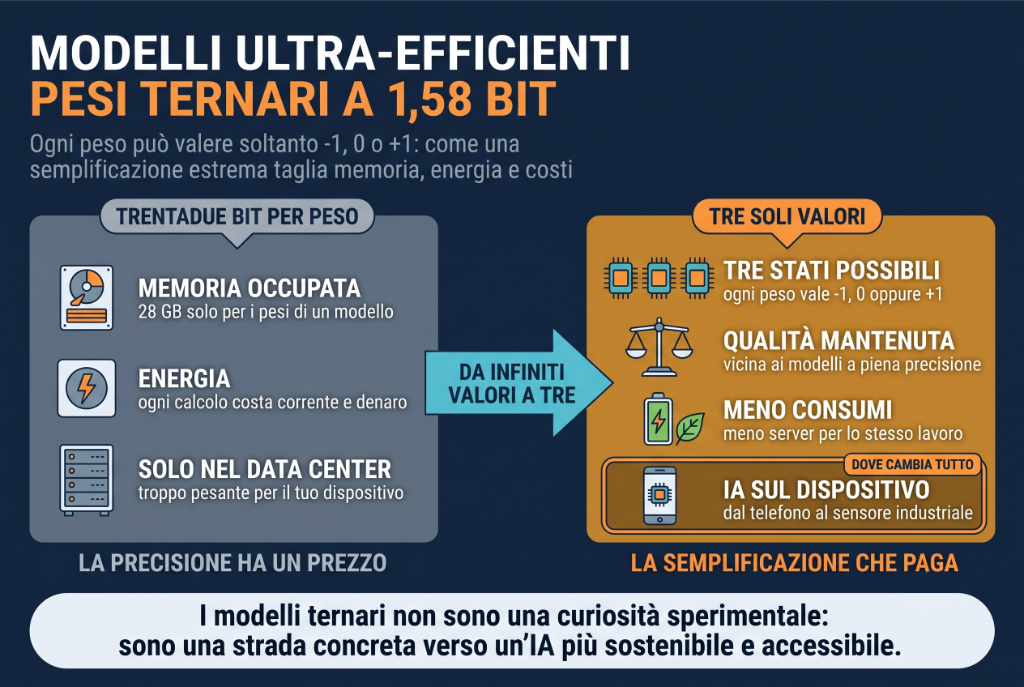
Negli ultimi anni i modelli di intelligenza artificiale sono diventati giganteschi. I cosiddetti Large Language Model (LLM) – come quelli che generano testi, rispondono a domande o aiutano a scrivere codice – funzionano grazie a miliardi di "pesi": numeri che regolano come il modello interpreta e produce il linguaggio.
Più sono precisi questi numeri, più l'IA riesce a cogliere le sfumature delle parole. Ma questa precisione ha un prezzo: ogni peso occupa spazio in memoria e richiede energia per i calcoli.
Il trucco: meno decimali, più efficienza
Tradizionalmente i pesi degli LLM sono memorizzati ciascuno in 32 bit, cioè sotto forma di numeri con molti decimali. È la scelta più sicura, perché riduce gli errori. Ma è anche la più costosa: un modello con 7 miliardi di parametri può arrivare a occupare 28 gigabyte solo per i pesi, senza contare la memoria aggiuntiva che serve per farlo funzionare.
Negli ultimi anni, i ricercatori hanno sperimentato modi per ridurre lo spazio occupato memorizzando i pesi in 16 bit, 8 bit o anche 4 bit. Ogni volta che si dimezzano i bit, si riduce la memoria necessaria e aumentano la velocità e l'efficienza.
L'innovazione Microsoft: 1,58 bit
Microsoft ha fatto un passo ulteriore e ha introdotto un'idea radicale: usare solo 1,58 bit per peso, cioè una rappresentazione ternaria. In pratica, invece di avere una (quasi) infinità di valori possibili, ogni peso può assumere solo uno dei tre valori: -1, 0 o +1. Una semplificazione estrema.
Perché questa tecnica è rivoluzionaria
Ridurre i pesi a soli tre valori potrebbe sembrare un impoverimento. In realtà è una scelta che apre nuove possibilità. Le sperimentazioni di Microsoft Research con BitNet b1.58 hanno mostrato risultati chiari:
- Un modello con soli 1,58 bit per peso può mantenere prestazioni comparabili a quelle dei modelli full-precision
- La riduzione di precisione porta a un taglio drastico dei consumi energetici e della memoria
- L'inferenza diventa più rapida e scalabile, con latenze ridotte senza perdita significativa di qualità
- Il rilascio open-source del modello rende la tecnica immediatamente disponibile alla comunità
Le conseguenze pratiche
Le conseguenze sono facili da immaginare:
-
Costi ridotti: I costi di gestione calerebbero drasticamente, perché servirebbero meno server e meno potenza di calcolo per ottenere gli stessi risultati
-
AI più accessibile: L'IA diventerebbe molto più vicina agli utenti, potendo essere eseguita non solo nei data center ma anche su laptop, smartphone o dispositivi industriali
-
Sostenibilità: Con consumi ridotti, l'intelligenza artificiale potrebbe crescere senza pesare in modo insostenibile sul fabbisogno energetico globale
Edge Computing e AI distribuita
Questa rivoluzione si collega in modo naturale al tema dell'edge computing, cioè l'elaborazione direttamente vicino alla fonte dei dati. Finora molti modelli di IA hanno avuto bisogno del cloud per funzionare, ma non sempre questo è l'approccio migliore: i dati devono viaggiare, la risposta può rallentare e la privacy non è garantita.
Con i modelli ternari, invece, è possibile portare capacità avanzate di intelligenza artificiale sui dispositivi locali – dagli smartphone ai sensori IoT, fino alle auto connesse – che hanno risorse limitate ma possono comunque gestirli grazie alla loro leggerezza.
Approfondimento tecnico
Rappresentazione in bit
Un computer lavora solo con bit (0 e 1). Ogni numero viene quindi "codificato" come una sequenza di bit. Più bit si usano, più valori diversi si possono rappresentare e con maggiore precisione.
I formati più comuni sono:
- FP16 (Floating Point a 16 bit): circa 3-4 cifre decimali affidabili
- FP32 (Floating Point a 32 bit): circa 7 cifre decimali affidabili
Come funziona la rappresentazione
Un numero in floating point viene memorizzato usando i bit in tre modi:
- Segno (1 bit): positivo o negativo
- Esponente: dice dove va messa la "virgola"
- Mantissa: contiene le cifre significative del numero
Il caso 1,58 bit
Un modello ternario come BitNet b1.58 utilizza solo tre valori possibili per i pesi: -1, 0, +1.
La domanda è: quanti bit servono per rappresentare tre stati diversi?
- Con 1 bit si rappresentano solo 2 stati (0 o 1) → insufficiente
- Con 2 bit si rappresentano 4 stati (00, 01, 10, 11) → più del necessario
La quantità esatta che serve è 1,58 bit: il valore medio minimo per rappresentare 3 stati. Nella pratica, non possiamo usare "mezzi bit" nei circuiti fisici, ma con tecniche di codifica e compressione si riesce a raggiungere questa media.
Conclusione
In conclusione, i risultati indicano che i modelli ternari a 1,58 bit non sono solo una curiosità sperimentale, ma rappresentano una strada concreta verso LLM più sostenibili, accessibili e diffusi, aprendo al tempo stesso nuove possibilità per il co-design di hardware ottimizzato.