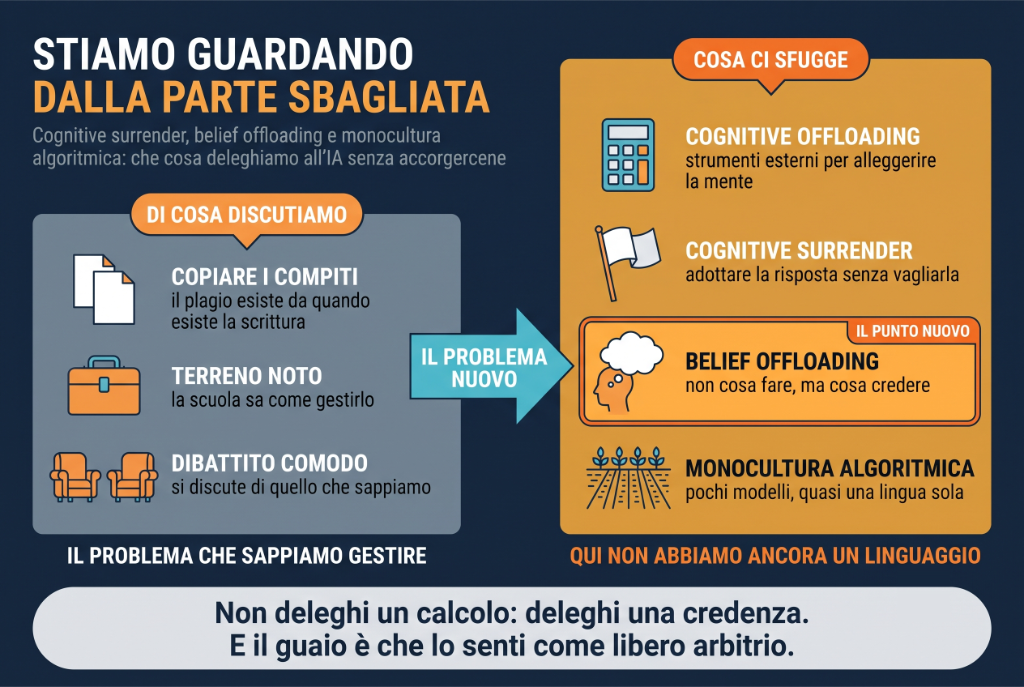
Da tre anni discutiamo se gli studenti usino ChatGPT per copiare. È una conversazione comoda perché si svolge su un terreno noto: il plagio esiste da quando esiste la scrittura, e la nostra cassetta degli attrezzi pedagogici ha imparato a gestirlo. La domanda interessante è un'altra, e in Italia quasi nessuno la sta facendo.
Riguarda quello che deleghiamo all'IA quando non ce ne accorgiamo - e che non è un calcolo o una memoria, ma il processo stesso con cui formiamo e sosteniamo le nostre opinioni.
Tre concetti, tre date
Per orientarsi serve una mappa. Tre termini che spesso vengono usati come sinonimi non lo sono - hanno autori diversi, anni diversi, forniscono leve diverse per riflettere sul problema.
In sintesi: il cognitive offloading (Risko e Gilbert, 2016) è il concetto madre che usiamo da dieci anni - usare strumenti esterni per ridurre il carico mentale, dalla calcolatrice alla rubrica dei contatti del telefono. È neutro. Il cognitive surrender è la versione patologica che gli economisti comportamentali della Wharton hanno misurato in laboratorio: in tre esperimenti pre-registrati su 1.372 partecipanti, quando l'AI dava la risposta giusta gli umani miglioravano di 25 punti percentuali di accuracy, ma quando sbagliava li trascinava giù di 15. Chi dichiara alta fiducia nell'IA ha 3,5 volte più probabilità di seguire un consiglio errato. Shaw e Nave propongono di estendere Kahneman aggiungendo un System 3: la cognizione artificiale che opera fuori dal cervello e può supplire o soppiantare i processi interni. Il belief offloading dei filosofi di Princeton (Guingrich, Mehta, Bhatt) è il caso più specifico: non deleghi un calcolo, deleghi una credenza - cioè qualcosa che poi guida le tue azioni e si propaga nella tua vita.
I due paper più recenti sono complementari, e il fatto che siano usciti nello stesso mese dice qualcosa: il problema sta emergendo come oggetto di studio organizzato proprio adesso, mentre noi continuiamo a discutere se gli studenti copiano i compiti.
Come succede davvero
Maria si trasferisce a Milano per lavoro e chiede a ChatGPT dove abitare. L'AI le suggerisce i Navigli, "perfetti per chi ha il tuo profilo". Maria ci va. Lì conosce persone, frequenta locali, sviluppa amicizie. Comincia a percepirsi come "una dei Navigli", a parlare come si parla lì, a leggere quello che si legge lì, a votare come si vota lì. Mai una scelta esplicita. Solo una catena di piccole deleghe che diventa identità.
L'esempio non è mio, è del paper di Guingrich, Mehta e Bhatt: loro usano Cambridge e il supermercato Waitrose, io l'ho italianizzato. Il punto è lo stesso. Il belief offloading non è un'astrazione filosofica, è quello che succede quando una scelta automatica si trasforma in un percorso che ti cambia. L'IA ti suggerisce qualcosa, tu agisci di conseguenza, l'azione rinforza la suggestione, col tempo quella diventa parte di chi sei. Il guaio è che lo senti come libero arbitrio.
Il dato strutturale
Allo Stanford AI+Education Summit di febbraio 2026, Amanda Bickerstaff (CEO di AI for Education) ha citato un numero da memorizzare: oltre 300 milioni di utenti attivi mensili sotto i 25 anni soltanto su ChatGPT, e sotto i 25 anni sta quasi metà di chi usa l'IA generativa. Quattro o cinque aziende, tutte concentrate tra Bay Area e Pechino, producono i modelli che mediano una quota crescente delle conversazioni che questi ragazzi hanno con il mondo del sapere.
Anche ai tempi di tre reti TV nazionali, l'informazione era broadcast: chi guardava sapeva di guardare un canale, riconosceva la voce di un giornalista, percepiva la cornice. Una conversazione con un chatbot è diversa per tre ragioni che si rinforzano. È personalizzata: la risposta sembra cucita sul proprio caso. È interattiva: la posso interrogare, e questo crea l'illusione di stare costruendo noi stessi la verità. È priva di marca visibile: il modello quasi mai dice "questa risposta deriva da un addestramento su questi corpus, con questi bias noti, da parte di questa azienda con questa storia di scelte editoriali".
Aggiungi che il modello, per progettazione, evita di dire "non so come pensarla". Smussa, media, cerca un punto di equilibrio fra le posizioni note. Su questioni controverse - bioetica, geopolitica, identità, religione - lo studente riceve quasi sempre una risposta che assomiglia a una sintesi ragionevole. Quella sintesi è una scelta editoriale fatta da qualcun altro, applicata al volo a milioni di conversazioni.
L'angolo italiano
Sui dati di addestramento, l'italiano pesa pochissimo. Le statistiche aggiornate del Common Crawl - il corpus web da cui i principali LLM ricavano gran parte del loro materiale di addestramento - dicono che nel 2026 l'italiano vale circa il 2,3% del totale, contro il 41% dell'inglese. È meno del francese (4,7%), del tedesco (5,9%), del russo (6,5%). Per Wikipedia e per i corpora curati la proporzione cambia, ma il quadro generale resta: l'italiano è una lingua minoritaria nel materiale che addestra i modelli più usati.
Conseguenza concreta: un adolescente italiano che si forma un'opinione su Mazzini, sul referendum del '46, sul rapporto fra Stato e Chiesa, sui diritti LGBTQ+ nel diritto di famiglia italiano, riceve una risposta che è in gran parte una traduzione di una sintesi anglofona. Senza che nessuno glielo dichiari.
Per le scienze dure il problema è marginale: la matematica non parla italiano. Per l'umanistica e per il civile è un punto centrale. Una generazione di liceali che impara a interrogare l'IA su Manzoni avrà letto - per via mediata - più Wikipedia in inglese che il proprio testo scolastico. Non è un disastro, è uno spostamento. Va nominato. E nelle Linee guida MIM 2025 - il quadro istituzionale che ho discusso qui - questa dimensione manca del tutto.
"Ma se il contenuto è corretto, dov'è il problema?"
È la contro obiezione più seria, e va affrontata. Se il modello mi spiega Kant in modo corretto, perché dovrebbe importare se l'opinione l'ho formata io o me l'ha consegnata l'AI?
Importa per due ragioni. La prima la dicono Guingrich et al.: una credenza non è solo il suo contenuto, è la rete di ragioni che la sostiene. Ricevere una sintesi corretta senza aver fatto il percorso di costruzione significa avere il risultato senza l'apparato di giustificazione che permette di rivederla, contestarla, applicarla a casi nuovi. Quando un caso atipico arriva - e arriva sempre - chi ha fatto il percorso sa adattarsi, chi ha solo ricevuto si trova a piedi.
La seconda è quella misurata da Shaw e Nave. Il loro esperimento ci dice che l'utente medio non scarta i suggerimenti sbagliati: li adotta. Il meccanismo è quello che il paper di Princeton chiama belief offloading automatizzato - il sistema consegna una conclusione "neutra, equilibrata, autorevole" e l'utente la recepisce senza vagliarla. La maggior parte delle interazioni studente-chatbot è di questo tipo. Il modello, per come è ottimizzato, minimizza la frizione al momento dell'uptake. Il dubbio non ha il tempo di nascere. È esattamente la dinamica che ho descritto parlando della sicofanzia dei modelli linguistici: un sistema che premia la soddisfazione dell'utente non premia la verità.
I due paper si parlano: Wharton fornisce la misura comportamentale (la gente si arrende all'IA in modo replicabile), Princeton fornisce il quadro normativo (cosa significa, per la nostra agency epistemica, che ci arrendiamo).
Una precisazione di posizione
Da un paio d'anni scrivo e divulgo intorno all'IA - questo libro, questa piattaforma. Sono dentro al coro che ripete: "non bisogna vietare, bisogna educare a usarla bene". Quella risposta è anche la mia, ma ne riconosco il limite.
Il limite è di tempo. L'alfabetizzazione critica funziona quando, fra la domanda e la risposta, esiste un margine in cui chi impara può fermarsi a dubitare - aprire un libro, confrontare due fonti, chiedere a un compagno, pensarci sopra una notte. La conversazione con un chatbot annulla quel margine. La risposta arriva mentre la domanda è ancora calda, già confezionata, già rivestita di una voce equilibrata e autorevole. Quella voce non è un involucro che si stacca dopo: arriva insieme al contenuto, lo orienta, ne pre-decide il peso. Insegnare a verificare dopo è un esercizio più tardivo, e più debole, di quello che il chatbot ha già fatto consegnandoti la risposta.
Le contromisure individuali esistono. Nell'articolo sulla sicofanzia ne ho elencate alcune: chiedere al modello di difendere la posizione opposta, nominare il fenomeno mentre accade, non premiare la capitolazione, ispezionare la memoria persistente. Funzionano, ma sono manutenzione individuale di un problema strutturale. La domanda centrale - chi disegna i guard rail del sistema, in quale lingua, con quali criteri - resta aperta.
E quindi
Non chiudo con la ricetta perché non ce l'ho. Ho due osservazioni e una domanda.
L'osservazione di metodo: smettiamo di chiamare "IA a scuola" il problema del plagio. Quello è il problema noto. Il problema nuovo è che pochi attori privati stanno mediando la formazione delle opinioni di un'intera generazione, in una lingua che non è quasi mai la nostra, senza che gli studenti se ne accorgano e senza che la scuola abbia ancora un linguaggio per parlarne.
L'osservazione politica: una pluralità di modelli - europei, italiani, open source - non è solo questione di sovranità tecnologica e di PIL. È questione di pluralismo epistemico, ed è quella che gli stessi autori del paper di Princeton, citando Kleinberg e Raghavan, chiamano monocultura algoritmica. Avere un modello solo è peggio che avere un giornale solo, perché il modello finge di essere uno strumento neutro mentre il giornale almeno aveva il decoro di firmarsi. Attenzione però: pluralità di modelli non equivale a pluralità di diete culturali. Se Mistral e Llama vengono addestrati sugli stessi corpora anglocentrici di GPT, la pluralità è nominale. Quella che serve è pluralità di dati di addestramento, in lingue e tradizioni diverse. Costa molto di più, e nessuno lo sta facendo davvero in scala.
La domanda che lascio aperta è per i professori che mi leggono. Quando uno studente vi porta una posizione che ha "elaborato con l'IA", riuscite a distinguere fra il caso in cui ha pensato e il caso in cui ha solo ricevuto?