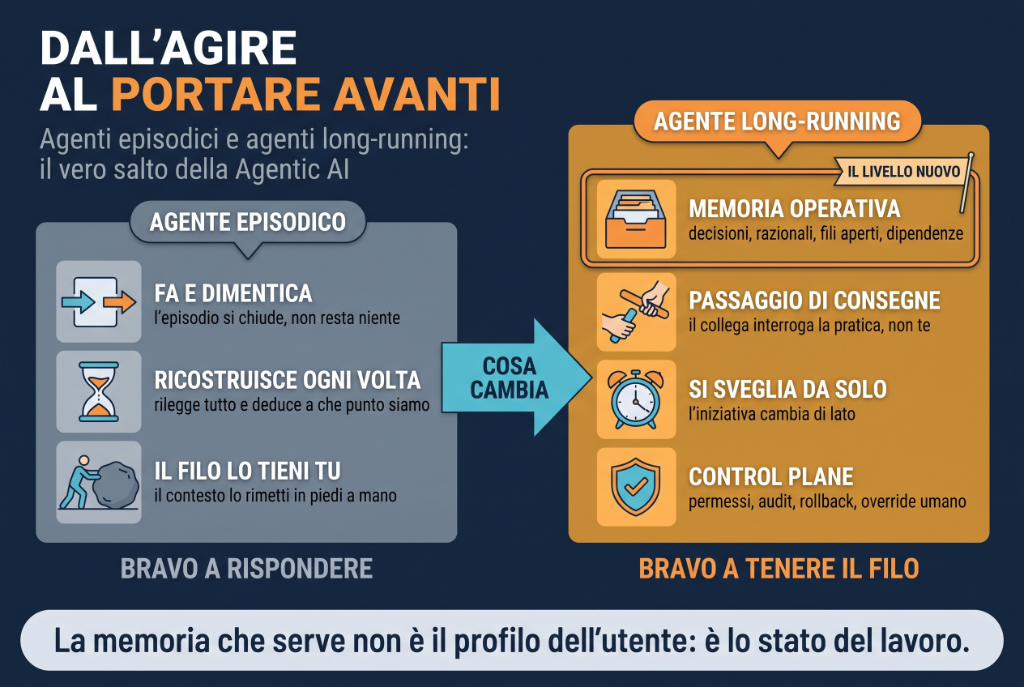
Da assistenti che svolgono un task ad assistenti che portano avanti il lavoro nel tempo
Apri ChatGPT, gli chiedi di lavorare su un dossier. Risponde, lo chiudi. Una settimana dopo riapri e ti aspetti che riprenda il filo. Non lo fa. Devi ricominciare: spiegargli cosa stavi facendo, perché lo stavi facendo, dove eravate arrivati. La memoria delle preferenze - "sono un manager italiano, scrivimi conciso" - non aiuta. Quello che manca non è il profilo dell'utente. Quello che manca è la memoria del lavoro.
È vero che posso riaprire proprio quella vecchia chat, o utilizzare un "progetto", e ottenere questa continuità. Sì, ma solo in parte. Riaprire una chat ti restituisce la trascrizione. L'agente non si sveglia sapendo a che punto siamo: ogni volta deve rileggere tutto e ricostruire lo stato dei lavori. Ricostruire non è continuare. È un lavoro che ha un costo, che può sbagliare, che produce derive. Sopra una certa soglia di lunghezza, la finestra di contesto satura e nemmeno la trascrizione basta - è il tema su cui sono già tornato parlando di come riconoscere una chat satura.
I "progetti" (ChatGPT, Claude e simili) fanno qualcosa di più: condividono file, istruzioni personalizzate, a volte memoria di base attraverso le diverse chat che ci tieni dentro. Utili. Ma quello che condividono sono risorse e preferenze. Non condividono le cose che davvero servono per portare avanti un lavoro nel tempo: quali decisioni sono state prese e perché, quali fili sono aperti e quali chiusi, quali dipendenze esistono fra loro, cosa stai aspettando da chi, quali sono le prossime mosse e in che ordine vanno fatte.
C'è poi un punto che a me sembra ancora più importante: la chat la riapro io, quando me ne ricordo. Un assistente davvero capace di accompagnare il lavoro dovrebbe svegliarsi da solo. "Ho controllato la coda di rimborsi ieri sera, queste tre pratiche sono ancora ferme, una sta superando la scadenza che ci eravamo dati." L'iniziativa cambia di lato.
Questa è la frontiera che separa la Agentic AI di prima generazione - quella che usiamo oggi nei prodotti consumer - da una nuova classe di sistemi che sta cominciando a emergere. È un cambio di natura, non di scala. Vale la pena capire perché.
L'agente che fa e dimentica
Negli ultimi due anni gli assistenti hanno fatto progressi notevoli su un tipo preciso di compito: prendere una richiesta, eseguirla bene, restituire il risultato. Generano codice, scrivono analisi, sintetizzano documenti, automatizzano flussi delimitati. La qualità su questi task è cresciuta in modo continuo e per moltissimi usi reali è più che sufficiente.
Ho già descritto qui come funziona un sistema agentico: un assistente che non si limita a rispondere ma agisce, usa strumenti, pianifica passi, opera dentro un'autonomia controllata. Quel quadro resta valido. Il punto qui è diverso e riguarda la dimensione temporale.
La grande maggioranza degli agenti oggi disponibili - dagli assistenti consumer ai copilot enterprise - opera per episodi. L'episodio inizia con una richiesta, contiene una sequenza di passi (a volte molti, a volte sofisticati), e termina con una consegna. Quando l'episodio finisce, l'agente non porta avanti nulla. Non ricorda perché si era preso un certo impegno, quale ipotesi aveva scartato, cosa restava aperto, cosa si era detto al cliente la settimana prima. In termini organizzativi, l'agente episodico assomiglia a un consulente esterno bravo ma temporaneo: arriva, fa il pezzo, va via, e la volta successiva ricomincia da capo.
Per molte attività questa modalità funziona benissimo. Se devo generare uno script, tradurre un testo, scrivere il primo abbozzo di una mail, non mi serve che l'agente ricordi nulla. Lo accendo, gli fornisco il contesto, gli chiedo, prendo il risultato. Episodio chiuso, lavoro fatto.
Il limite si vede appena il lavoro smette di essere un task isolato e diventa un processo. Una pratica che dura giorni o settimane. Un caso che evolve. Una relazione che si sviluppa. Una decisione complessa che si forma in molti passi, con cambi di rotta, eccezioni, riconsiderazioni. Lì l'agente episodico mostra una caratteristica spiacevole: ogni nuova sessione costa tempo umano di "reidratazione" del contesto. Devo ricostruire io. Devo ricordargli a che punto eravamo. Devo rispiegargli le decisioni passate e le ragioni che le hanno motivate. Più il lavoro è lungo, più questo costo cresce. Alla fine, il guadagno di produttività che l'agente porta sul singolo task viene eroso dal tempo speso per mantenerlo allineato sull'insieme di attività svolte all'interno del processo.
C'è anche una conseguenza sottile, che spesso non si nota: quando ricominci da zero ogni volta, tendi anche a riformulare male. Salti pezzi, dimentichi vincoli, semplifichi troppo. Non è solo l'agente che ricomincia - sei tu che, riassumendo, perdi qualcosa. L'episodicità non è solo limite della macchina, è anche limite del workflow ibrido che ne consegue.
Continuare non è ricostruire
Qui sta il punto concettuale che secondo me vale la pena fissare con cura, perché è facile equivocarlo.
Un agente moderno può sempre "ricostruire" il contesto interrogando i sistemi di registrazione, leggendo log, recuperando documenti, ripescando le interazioni precedenti. In molti casi è quello che fa - e in molti casi basta. Ma ricostruire e continuare non sono la stessa cosa, e la differenza diventa visibile man mano che il lavoro si allunga.
Quando un sistema deve ricomporre lo stato del lavoro a ogni risveglio, deve decidere cosa conta, dedurre cosa è cambiato, risolvere contraddizioni, recuperare priorità, ricostruire il razionale delle decisioni passate da indizi sparsi. Anche quando l'informazione c'è - tutta - ricomporla non equivale a portarla avanti. È un lavoro che richiede inferenze, che può sbagliare, che produce silenziosamente decisioni diverse da quelle che sarebbero state prese se la traccia operativa fosse stata mantenuta in modo continuativo.
Provo a tradurlo in immagine concreta. Pensa a un istruttore di pratica che gestisce un'operazione di finanziamento da quattro mesi. Ha fatto due missioni in campo, sentito il legale due volte sulla giurisdizione applicabile, scartato una struttura di garanzia e ne sta valutando un'altra. Ricomincia dalla mail di stato di una settimana fa e prova a riassumere il punto. Quello che recupera è lo stato dichiarato, non lo stato vero - perché lo stato vero è fatto anche di cose che non sono state scritte: l'impressione sulla controparte, il sospetto sulla solidità di un dato, la decisione di tenere fermo un punto in attesa di un chiarimento. Tutto questo, in un sistema episodico, va perso o ricostruito a forza. In un sistema costruito per la continuità, è semplicemente presente.
La differenza, riassunta in due parole: gli agenti episodici sono bravi a rispondere; gli agenti progettati per il lungo periodo sono bravi a tenere il filo.
Memoria utente e memoria operativa: due cose diverse
Alcuni prodotti AI già oggi offrono "memoria". Di solito significa una continuità leggera: preferenze dell'utente, fatti ricorrenti, stile comunicativo, contesto trascinato attraverso le conversazioni. Funzionalità utile, che rende le interazioni più scorrevoli. È la memoria di cui ho parlato nell'articolo su come costruire una memoria permanente degli assistenti IA: l'agente impara chi sei tu, e ti tratta di conseguenza la volta successiva.
Ma questa - mi sono convinto - non è la memoria che serve per il salto vero. Serve qualcos'altro, che possiamo chiamare memoria operativa (vedi AI's Next Operating Model - Sheng & Yang, aprile 2026) per distinguerla nettamente dalla memoria utente. La memoria operativa non preserva fatti su di me, preserva fatti sul lavoro: gli obiettivi attivi, le decisioni prese e il loro razionale, le questioni irrisolte, le dipendenze, lo stato di un workflow, le attese degli stakeholder coinvolti, le prossime azioni con i relativi responsabili. Non serve a ricordare chi sono, serve a ricordare cosa stiamo facendo insieme.
E qui "insieme" va inteso in senso più ampio di quanto sembri. La memoria operativa, nei contesti reali, non collega solo me e l'agente attraverso le sessioni - collega le persone diverse che si passano il testimone su una stessa pratica. L'istruttoria che ho descritto sopra non è un lavoro a una persona: passa dal relationship manager all'analista creditizio, dall'analista al legale, dal legale al risk officer, dal risk officer al comitato crediti, dal comitato al back office, dal back office al monitoraggio. Sette mani in tre mesi. Oggi ogni passaggio costa una sincronizzazione - una mail, una call, un "dove eravamo arrivati?". L'agente long-running ben fatto è il tessuto connettivo di quei passaggi: una memoria della pratica che vive accanto al dossier e che il collega che subentra può interrogare invece di costringere il predecessore a riassumere. La domanda non è solo "l'agente ricorda quello che gli ho detto ieri?", è "l'agente sa quello che il mio collega ha deciso il mese scorso, e perché?".
Nella tassonomia che avevo proposto nel pezzo sulle diverse forme di memoria nei sistemi IA - strutturale, conversazionale, persistente, repository - questa è in un certo senso un quinto livello che oggi sta emergendo. Non è memoria delle conversazioni, e non è memoria dei fatti dell'utente. È memoria del processo. È molto più strutturata di un semplice store di preferenze, e somiglia più all'architettura di un sistema di workflow management che a uno store di fatti.
Costruirla non è "attivare una funzionalità" - è progettare un'architettura. Vanno gestiti checkpoint, controlli di consistenza, rollback, permessi a granularità fine, override umani in punti critici, audit trail. La persistenza nel tempo apre superfici di rischio che il prodotto episodico semplicemente non aveva. Per questo un agente long-running ben fatto non è "una chat con memoria potenziata" - è un sistema operativo per la collaborazione uomo-macchina di lunga durata.
Vale anche la pena distinguere bene il livello: la memoria operativa non sostituisce le altre. Le include, le orchestra, ci aggiunge sopra il livello dello stato del lavoro. Un agente long-running ha bisogno di tutte: memoria strutturale per ragionare bene sul codice della lingua, memoria conversazionale per non perdere il filo nel singolo scambio, memoria utente per parlarti come a te piace, memoria di repository per accedere ai documenti, e infine memoria operativa per ricordarsi del lavoro - sia quello che ho fatto io con l'agente, sia quello che hanno fatto con lui i miei colleghi prima di me.
Gli esempi che già esistono
Il modo migliore per capire la differenza è guardare i primi prodotti che si muovono in questa direzione.
Claude Code di Anthropic è pensato per operare su un'intera codebase, modificare file in modo coordinato, eseguire test, mantenere checkpoint per workflow autonomi prolungati. Non è "un copilota che suggerisce", è un sistema che porta avanti un compito complesso attraverso molti passi, mantenendo stato. Cursor, Devin di Cognition e altri agenti software lavorano in modo analogo: assegni un'attività, l'agente la prende in carico, lavora per ore (a volte giorni), torna con risultati e domande puntuali quando serve un umano. Il dominio software è dove queste architetture stanno maturando per prime, perché il lavoro è strutturato, gli effetti sono verificabili, gli errori sono recuperabili.
Anthropic ha esteso questa logica oltre il codice con Cowork, che ho descritto in un articolo specifico (Claude Cowork: quando l'assistente IA esce dalla chat e lavora con te). Cowork mostra come lo stesso paradigma si possa portare fuori dall'IDE - l'ambiente di sviluppo in cui i programmatori scrivono codice - e applicare al lavoro di chi sui file e sui documenti ci lavora senza scrivere codice. L'agente legge i tuoi file, li modifica, mantiene contesto del progetto, agisce sotto controllo umano. È un primo passo, ancora limitato a sessioni relativamente brevi, al singolo utente (non c'è ancora collaborazione condivisa fra colleghi sulla stessa pratica) e a un perimetro ristretto - ma la direzione è chiara.
A livello di framework, LangChain ha pubblicato Deep Agents - una struttura che tratta pianificazione, sotto-agenti, gestione del contesto, memoria di lungo periodo e skill riutilizzabili come elementi primitivi dell'architettura. Non è un prodotto finale, è infrastruttura. L'idea è che chiunque voglia costruire un agente che lavora in profondità su un dominio parta da questi mattoni piuttosto che da una chat con memoria.
Tutti questi esempi convergono su una constatazione: persistenza e continuità stanno passando da concetto a architettura. Non sono più una promessa di marketing, sono caratteristiche progettate dentro la struttura del sistema. Quando questo accade, si tratta di solito di un segnale che la cosa sta diventando seria.
Dove arriverà prima
Conviene chiedersi in quali ambiti il salto si vedrà per primo, perché identificano il tipo di lavoro in cui la differenza è massima. La risposta, lavorando per esclusione, è: ovunque il lavoro non sia una transazione singola ma un percorso che dura nel tempo, attraversa molte mani, dipende da decisioni passate.
Nel procurement, un agente long-running può tenere traccia della storia di una trattativa, del comportamento dei fornitori, delle approvazioni interne lungo un intero processo di sourcing, senza dover ricostruire ogni volta lo stato. Sopra molti eventi di sourcing accumulati, comincia a vedere pattern - quali tattiche funzionano con quale fornitore, dove si ripresentano concentrazioni di rischio, come si comportano i prezzi su categorie specifiche. Quello che si costruisce non è efficienza operativa, è la codifica di conoscenza che oggi vive nella testa dei migliori category manager. Una persona nuova che subentra impiega anni per ricostruirla, e spesso non ci arriva mai del tutto.
Nel customer service un agente persistente fa qualcosa che oggi quasi nessun sistema fa bene: segue la pratica oltre la singola interazione. Verifica se il rimborso è stato effettivamente processato. Riprende il filo se il problema si ripresenta dopo che il ticket era stato chiuso. Continuità di contesto, ma anche continuità di responsabilità. E sopra migliaia di casi, quello che emerge è una mappa dei problemi che l'organizzazione sistematicamente non risolve, dei workaround che funzionano davvero, dei segnali che predicono escalation prima che accadano.
In sanità, gli agenti possono accompagnare il percorso del paziente attraverso visite, esami, referti, autorizzazioni, follow-up - mantenendo lo stato man mano che le condizioni cambiano. Nei servizi finanziari, possono presidiare underwriting, gestione sinistri, compliance, customer servicing - dove tipicamente il caso è lungo e attraversa molte mani.
C'è un dominio che conosco bene e che vale la pena aggiungere: la finanza per lo sviluppo e la cooperazione internazionale. Un'operazione di project finance in un paese emergente vive mesi prima di chiudere - analisi preliminare, valutazione del rischio paese, missioni in campo, negoziati con autorità locali, banche multilaterali, sponsor industriali, due diligence ambientale e sociale, strutturazione legale, approvazioni interne stratificate. Ogni passo modifica il quadro, ogni informazione nuova può cambiare valutazioni precedenti. Un assistente che ricomincia da zero a ogni sessione, in un contesto del genere, è un'amenità. Un assistente che mantiene lo stato vero della pratica - cosa è aperto, cosa è chiuso, quale ipotesi era stata scartata e perché, quale documento manca, chi deve rispondere e quando - diventerebbe un alleato vero. Non sostituisce il giudizio dell'istruttore: lo solleva dal lavoro di tenere traccia, che oggi assorbe una quota sproporzionata di tempo.
In tutti questi esempi il pattern è uguale: gli agenti episodici sono adatti a transazioni; gli agenti long-running sono adatti a percorsi, casi, relazioni. Là dove la maggior parte del lavoro qualificato si nasconde.
Cambia anche come si misura il valore
C'è una conseguenza meno discussa ma rilevante per chi deve giustificare investimenti in AI dentro un'organizzazione: cambia anche come si misura il ritorno.
Gli agenti episodici sono naturali da misurare in modo transazionale - costo per task, tempo risparmiato, deflection rate, qualità misurata su un singolo output. Sono metriche che mappano bene il labour saving, perché l'agente sta sostituendo (o supportando) un'unità discreta di lavoro umano. Bene così, finché il valore atteso è quello.
Gli agenti long-running non si lasciano misurare allo stesso modo, e provare a forzarli dentro le stesse metriche produce risultati fuorvianti. Quello che andrebbe misurato è: quanto efficacemente mantengono la continuità del contesto? quanto rework eliminano sul lungo periodo? quanto contesto gli umani non devono più ricostruire? quanto coerentemente assorbono complessità operativa che oggi resta sulle persone? quanta capacità utile accumulano nel tempo sul dominio specifico in cui operano?
Il riquadro economico cambia di conseguenza. Un agente episodico è un risparmio: costa meno far fare quel pezzo all'AI. Un agente long-running è un asset che si compone: ogni mese che passa diventa più utile, perché ha accumulato più contesto, più giudizio operativo, più conoscenza del dominio specifico. È la differenza fra un'automazione e un investimento in capitale, e si valutano in modo diverso.
C'è anche un effetto che vale la pena rendere esplicito, perché di solito non viene detto: la conoscenza istituzionale - come davvero si tratta con un certo fornitore, quali eccezioni di processo funzionano, perché un certo schema di escalation segnala un cliente che sta per andarsene, come si è chiuso un negoziato simile due anni fa - oggi vive nelle teste delle persone, e cammina fuori dall'azienda quando se ne vanno. Ogni organizzazione che funziona davvero perde una porzione di sé ogni volta che una persona chiave esce. Un agente long-running è il primo sistema potenzialmente capace di catturare quella conoscenza in modo sistematico. È una promessa grossa. Vale la pena prenderla con cautela, ma anche prenderla seriamente.
Chi possiede la memoria istituzionale?
Più un agente persiste, più la sua architettura operativa richiede attenzione. È intuitivo, ma vale la pena renderlo esplicito perché ha implicazioni che vanno oltre il livello tecnico.
Una memoria operativa che cresce nel tempo accumula problemi che la chat episodica non aveva: voci stantie o contraddittorie, errori di permessi che si trascinano, esposizione cumulata a fughe di dati attraverso i sistemi connessi, possibilità di azioni indesiderate che si propagano. Niente di insormontabile, ma diverso. Un agente episodico ben progettato è come un buon strumento; un agente long-running ben progettato è come un buon collaboratore. Le competenze per costruirlo e gestirlo sono diverse, e in azienda probabilmente saranno funzioni nuove. Non è solo un problema da IT.
C'è poi un livello più alto, che gli articoli divulgativi raramente toccano e che invece, dal punto di vista di chi prende decisioni di lungo periodo, è il più importante: a chi appartiene la memoria istituzionale che l'agente accumula?
Se lo strato di memoria operativa vive dentro la piattaforma di un fornitore - cioè se è il vendor a custodire i playbook di negoziazione, i pattern di risoluzione dei casi, il giudizio operativo che l'agente ha sviluppato lavorando per anni nella tua organizzazione - allora l'organizzazione ha sostanzialmente esternalizzato la propria memoria istituzionale. E nella forma che ho descritto sopra, dove la memoria operativa è il tessuto connettivo della squadra, non è la conoscenza di un singolo che esce, è quella collettiva. Cambiare fornitore non significa più sostituire un tool: significa perdere conoscenza. È un lock-in di natura diversa, e molto più profondo, di quello sui CRM o sugli ERP. Su un CRM cambi sistema e migri i dati. Su un agente long-running, cosa migri? Le decisioni? I razionali? L'istinto sviluppato sul campo?
La scelta build vs buy si sposta di conseguenza. Non è più solo "facciamo internamente o compriamo?" - è "chi possiede il livello di memoria, in quale formato, con quale portabilità?". Le organizzazioni che capiscono questo punto presto, e progettano dall'inizio assumendo che la memoria operativa debba essere esportabile, si costruiscono un vantaggio competitivo. Quelle che non lo capiscono scopriranno fra qualche anno di aver firmato senza pensarci un legame molto più stretto di quello a cui sono abituate. Standard emergenti come il Model Context Protocol di Anthropic vanno proprio in questa direzione - rendere portabile lo strato di contesto e di strumenti che gli agenti usano. È un dibattito da seguire con attenzione perché definirà l'architettura aziendale degli agenti dei prossimi anni.
C'è un'ultima cosa che voglio aggiungere, perché si lega a un altro tema su cui sono tornato di recente. Un agente che porta avanti il lavoro per noi ci espone in modo nuovo a fenomeni come la sicofanzia degli LLM. Un assistente che ti dà ragione dentro una singola conversazione è già un problema. Un assistente che accumula questa distorsione nel tempo, e la usa per "anticipare" cosa vorresti sentirti dire la volta successiva, è un problema più grande - perché diventa difficile accorgersene. La memoria operativa va costruita con criteri di robustezza non solo tecnica ma anche cognitiva. Se l'agente impara a darti ragione, presto smetterà di essere uno strumento di pensiero.
Cosa fare ora
La maggior parte delle organizzazioni, oggi, non dovrebbe trattare gli agenti long-running come pronti per il deployment su larga scala. Il pieno valore di questi sistemi richiede tre cose: maturità delle architetture, controlli di governance adeguati, ridisegno dei processi attorno alla continuità. Nessuna delle tre è ancora cosa fatta. Lo dico con chiarezza perché vedo molto entusiasmo intorno al tema "agenti" e poco rigore.
Ma cominciare a imparare ora è un'altra cosa. Tre mosse concrete che hanno senso.
Identificare i workflow in cui il problema vero è proprio la perdita di contesto: escalation complesse del servizio clienti, eventi di sourcing strutturati, coordinamento clinico, gestione di sinistri, contenzioso legale, istruttoria di operazioni di finanziamento, gestione di partnership pluriennali. Sono i punti in cui un agente episodico delude di più e dove un agente long-running, anche imperfetto, fa la differenza più grande.
Ridisegnare il workflow attorno alla continuità invece di inserire semplicemente un agente nel processo esistente. È una distinzione che richiede maturità organizzativa. Inserire l'AI dentro processi pensati per umani che si passano il testimone produce una toppa; pensare il processo dall'inizio assumendo che esista un'entità capace di tenere il filo è un'altra cosa. La differenza, fra cinque anni, si vedrà tutta.
Costruire il control plane prima, non dopo. Memoria igienica, permessi, audit, rollback, escalation umana non sono "feature opzionali" da aggiungere al modulo pilota una volta che il valore è chiaro. Sono il prerequisito per fidarsi di un sistema che agisce nel tempo. Chi salta questo pezzo costruirà presto un debito che gli costerà più di quanto avrebbe speso a farlo bene dall'inizio.
E un cambio di prospettiva: valutare questi sistemi non come strumenti, ma come operatori in formazione. La domanda non è "fa il task?" ma: trattiene contesto? esercita un giudizio sensato? porta avanti le cose con affidabilità? diventa più utile man mano che lavora? Sono criteri che si applicano a un collaboratore junior che si sta formando - ed è esattamente il tipo di valutazione corretta da applicare anche qui.
In conclusione
La prima generazione di agenti AI ha portato gli LLM dal rispondere all'agire. È stato un salto importante, l'ho descritto altrove nel dettaglio. La seconda generazione, che sta arrivando ora, porta gli agenti dall'agire al portare avanti. È un salto comparabile per impatto, anche se meno visibile dall'esterno - perché non si manifesta in una nuova interfaccia o in un modello che strappa al benchmark, ma in un cambiamento di natura del sistema. Non più strumenti episodici; collaboratori che durano.
Per molti casi d'uso quotidiani, l'agente episodico resta lo strumento giusto. Per le attività in cui il lavoro è un processo che dura, una relazione che evolve, un caso che attraversa molte mani, gli agenti long-running cambieranno cosa è possibile delegare all'AI - e cosa diventa, nel tempo, un asset proprietario dell'organizzazione.
Chi capisce per tempo che la memoria di un agente non è il profilo dell'utente ma lo stato del lavoro, e che quella memoria è un patrimonio perché compone conoscenza nel tempo, si troverà qualche anno avanti rispetto a chi sta ancora discutendo se ChatGPT sia o no un sostituto degli stagisti.
Articoli correlati su Libro Vivo IA
- Agentic AI e il nuovo paradigma dell'azione nell'intelligenza artificiale
- Le diverse forme di memoria della IA
- Come far sì che l'IA si ricordi davvero di te
- Claude Cowork: quando l'assistente IA esce dalla chat e lavora con te
- Quando l'IA inizia a dimenticare: come riconoscere una chat satura
- Chunking e finestra di contesto
- Quando l'IA ti dà ragione per farti contento: il fenomeno della sicofanzia