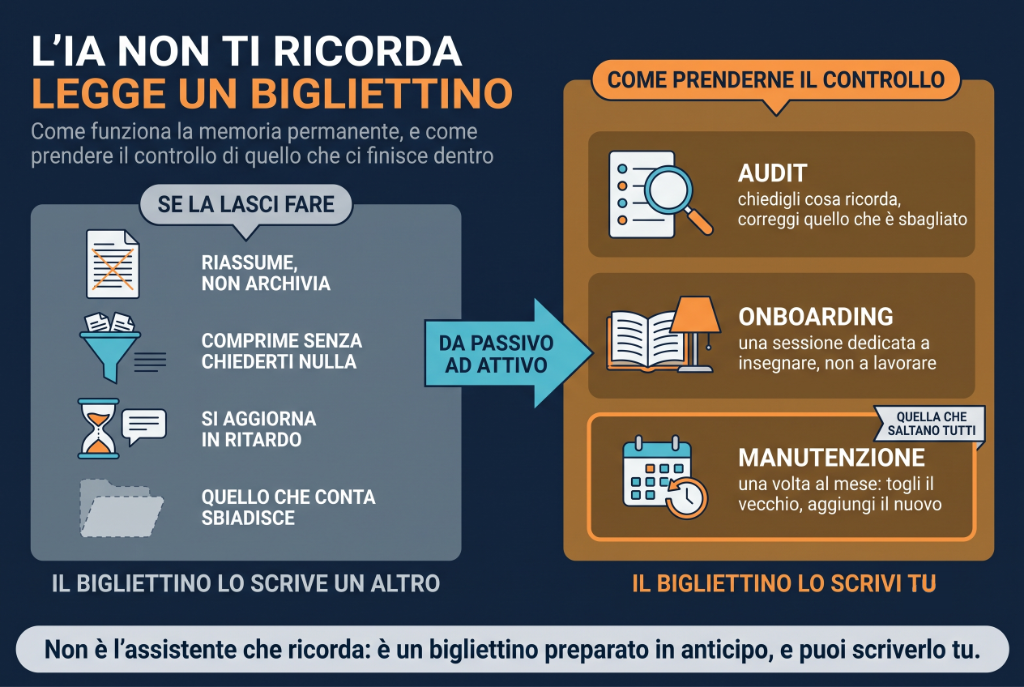
Dopo qualche settimana di uso regolare, inizi a notare qualcosa di strano. Apri una chat nuova con ChatGPT o Claude, scrivi una domanda sul tuo lavoro, e l'assistente risponde come se ti conoscesse già. Sa in che settore lavori. Usa il tono che preferisci. A volte fa riferimento a progetti di cui avete parlato giorni fa.
Non te lo sei sognato. È successo davvero qualcosa: l'assistente ha imparato a conoscerti.
Ma come funziona? E soprattutto: puoi influenzare cosa impara?
Aggiornamento — agosto 2026. Le implementazioni concrete sono cambiate rapidamente. ChatGPT dispone di una memoria aggiornata che riorganizza automaticamente le informazioni rilevanti e le rende verificabili anche in una sintesi dedicata. Claude costruisce invece voci di memoria aggiornate in tempo reale, separate per progetto, e consente anche di importare o esportare la memoria. Il modello mentale del “briefing” resta utile, ma tempi, controlli e rapporto con la cronologia dipendono dalla piattaforma.
Il bigliettino che arriva prima di te
Immagina questa scena. Ogni volta che apri una nuova conversazione (una nuova chat), l'assistente IA parte completamente da zero - nessun ricordo delle chat precedenti, nessuna memoria di chi sei. È una lavagna bianca.
Ma un attimo prima che tu scriva il primo messaggio, qualcuno gli passa un bigliettino. Su quel bigliettino c'è scritto qualcosa del tipo: "Stai per parlare con Marco. È un consulente che lavora nel settore energetico. I suoi progetti principali riguardano la transizione ecologica. Preferisce risposte dirette e strutturate. Ultimamente sta lavorando a una gara importante."
L'assistente legge il bigliettino, e poi tu scrivi "Ciao". Per te è una chat nuova. Per lui, sei già una persona con un contesto.
Quel bigliettino è la memoria permanente. Non è l'assistente che "ricorda" - è un sistema separato che ha analizzato le tue conversazioni passate, ne ha estratto le informazioni salienti, e le ha sintetizzate in un profilo. Quel profilo viene consegnato all'assistente all'inizio di ogni nuova chat.
Ecco perché sembra che ti conosca: qualcuno gli ha fatto un briefing su di te.
La domanda interessante è: chi scrive quel bigliettino? E puoi decidere tu cosa ci finisce sopra?
La risposta breve è: sì, puoi. E farlo cambia radicalmente l'utilità dell'assistente.
In precedenti articoli abbiamo visto cosa succede quando una singola chat si satura e l'assistente perde il filo e quali sono i diversi tipi di "memoria" della IA. Ora facciamo il passo successivo: capire come prendere il controllo di quel bigliettino, la memoria permanente.
Da utente passivo ad architetto della memoria
La maggior parte delle persone usa gli assistenti IA in modo reattivo. Aprono una chat, fanno una domanda, ottengono una risposta. Se l'assistente "ricorda" qualcosa di loro, tanto meglio; se non lo fa, pazienza - si spiega di nuovo.
Questo approccio funziona per usi occasionali, ma diventa inefficiente quando l'assistente è uno strumento di lavoro quotidiano. Ogni volta che devi rispiegare chi sei, su cosa lavori, quali sono le tue preferenze, stai sprecando tempo e spazio nella finestra di contesto. Stai anche ottenendo risposte meno precise, perché l'assistente parte da zero invece che dal contesto accumulato.
L'alternativa è assumere un ruolo attivo nella costruzione della memoria. Non aspettare che il sistema capisca da solo cosa è importante: dirglielo esplicitamente. Non sperare che le informazioni giuste persistano: verificarlo e correggere. Non trattare la memoria come una scatola nera: aprirla, ispezionarla, ottimizzarla.
Questo richiede di capire come funziona il sistema sotto il cofano - non nei dettagli tecnici, ma nei principi operativi che determinano cosa viene ricordato, come, e per quanto tempo.
Anatomia della memoria permanente
La memoria permanente non coincide con un archivio integrale delle conversazioni. A seconda della piattaforma può assumere la forma di ricordi salvati, voci organizzate per categoria, una sintesi aggiornata o un recupero selettivo dalla cronologia. Queste informazioni vengono poi richiamate nel contesto di una nuova conversazione. Per questo è importante distinguere tra chat, memoria salvata e memoria di progetto: possono avere controlli e tempi di conservazione diversi.
Il meccanismo ha tre caratteristiche fondamentali che determinano come puoi sfruttarlo.
Prima caratteristica: è un riassunto, non un database. Il sistema non salva i dettagli operativi delle tue sessioni di lavoro. Salva pattern, preferenze, informazioni stabili. Sa che sei un consulente che lavora con clienti nel settore energetico; non sa che ieri stavi preparando la slide 14 della presentazione per il certo cliente.
Questo significa che la memoria permanente è adatta per informazioni strutturali - chi sei, come lavori, quali sono i tuoi standard - ma non per lo stato corrente dei tuoi progetti. Per quello serve la finestra di contesto o, meglio ancora, documentazione esterna.
Seconda caratteristica: viene compressa aggressivamente. Mesi di conversazioni diventano pochi paragrafi. Il sistema deve decidere cosa è rilevante e cosa no, e questa decisione non sempre coincide con le tue priorità. Un dettaglio che per te è cruciale potrebbe essere scartato perché il sistema non ne riconosce l'importanza.
Questo significa che non puoi affidarti alla memoria passiva per le informazioni che contano davvero. Devi renderle esplicite, ripeterle, verificare che siano state registrate.
Terza caratteristica: modalità e tempi di aggiornamento cambiano. Le versioni più recenti possono aggiornare la memoria durante la conversazione o riorganizzarla automaticamente; alcune esperienze legacy continuano invece a produrre sintesi periodiche. Anche la cancellazione di una chat non equivale sempre alla cancellazione di un ricordo salvato separatamente. La regola prudente è verificare il pannello Memoria della piattaforma e rimuovere esplicitamente ciò che non vuoi venga riutilizzato.
Questo significa che per cambiamenti importanti non basta dirlo una volta e sperare. Devi verificare nelle sessioni successive che l'aggiornamento sia effettivamente avvenuto.
Il modello mentale corretto: istruire un nuovo collaboratore
L'analogia più utile per capire come gestire la memoria permanente è pensare all'assistente come un nuovo collaboratore che si unisce al tuo team.
Quando arriva una persona nuova, non le racconti tutta la storia dell'azienda dal primo giorno. Le dai un onboarding strutturato: chi siamo, cosa facciamo, come lavoriamo, quali sono le regole non scritte. Poi, man mano che lavorate insieme, questa persona accumula conoscenza contestuale - impara i tuoi standard, capisce le tue preferenze, anticipa le tue esigenze.
Con l'assistente IA il processo è simile, ma con alcune differenze cruciali. La prima è che l'assistente non ha una memoria episodica: non ricorda le singole sessioni di lavoro, solo il profilo aggregato. La seconda è che l'assistente non inferisce autonomamente cosa è importante: devi dirglielo tu. La terza è che l'assistente può "dimenticare" se non rinforzi periodicamente le informazioni chiave.
Questo significa che devi strutturare consapevolmente l'onboarding e la formazione continua del tuo assistente, esattamente come faresti con un collaboratore umano - anzi, con più attenzione, perché il sistema non compensa le tue dimenticanze.
Cosa mettere nella memoria permanente
Non tutto merita di essere nella memoria permanente. Alcune informazioni sono troppo volatili, altre troppo specifiche, altre ancora semplicemente irrilevanti. La chiave è identificare cosa produce il massimo ritorno in termini di qualità delle risposte.
Livello 1: Il tuo profilo professionale
Questo è il fondamento. Include chi sei, cosa fai, qual è il tuo ruolo, quali sono le tue competenze principali. Non serve un curriculum completo - servono le informazioni che permettono all'assistente di calibrare le risposte al tuo livello e contesto.
Per esempio: "Sono un project manager in una società di consulenza che lavora principalmente con clienti del settore pubblico. Ho competenze tecniche in analisi dati e una formazione economica. Gestisco team di 5-10 persone."
Questo tipo di profilo permette all'assistente di evitare spiegazioni troppo basilari quando parli di gestione progetti, di usare terminologia appropriata per il settore pubblico, di considerare le dinamiche tipiche della consulenza quando discutete strategie.
Livello 2: Le tue preferenze di comunicazione
Come vuoi che l'assistente ti parli? Preferisci risposte concise o analisi dettagliate? Vuoi che sollevi dubbi e alternative o che esegua quello che chiedi? Ti aspetti un tono formale o colloquiale?
Queste preferenze sembrano secondarie ma hanno un impatto enorme sull'utilità delle risposte. Se ogni volta devi chiedere "sii più sintetico" o "dammi più dettagli", stai sprecando interazioni. Se l'assistente conosce le tue preferenze, parte già calibrato.
Per esempio: "Preferisco risposte strutturate con bullet point per argomenti complessi. Quando c'è ambiguità, preferisco che tu faccia domande di chiarimento invece di assumere. Per documenti e email, uso un tono professionale ma non burocratico."
Livello 3: Il contesto dei tuoi progetti
Questo è il livello dove la memoria permanente diventa davvero potente. Se lavori su progetti a lungo termine, l'assistente dovrebbe conoscerne l'esistenza e le caratteristiche principali - non i dettagli operativi, ma il quadro generale.
Per esempio: "Sto lavorando a tre progetti principali: (1) la riorganizzazione del sistema di reporting per il cliente Alfa, che deve concludersi entro marzo; (2) una gara per servizi di consulenza strategica nel settore trasporti; (3) lo sviluppo di un tool interno per la gestione del tempo."
Con questo contesto, quando apri una nuova chat e dici "devo preparare la presentazione per Alfa", l'assistente sa già di cosa stai parlando. Non devi rispiegare cosa è il progetto Alfa, cosa state facendo, qual è la timeline.
Livello 4: I tuoi standard e le tue regole
Questo è il livello più avanzato e potenzialmente più utile. Se hai sviluppato metodologie, template, convenzioni che usi regolarmente, l'assistente dovrebbe conoscerle.
Per esempio: "Quando preparo presentazioni uso sempre la struttura: contesto-problema-soluzione-prossimi passi. I documenti di progetto seguono il template aziendale con executive summary, analisi, raccomandazioni, appendici. Per le email ai clienti uso sempre il formato: saluto personalizzato, un paragrafo di contesto, richiesta o informazione principale, call to action chiara, chiusura cordiale."
Con queste regole in memoria, l'assistente non produce output generici che poi devi rifare. Produce output già allineati ai tuoi standard.
Come costruire la memoria in modo sistematico
La costruzione della memoria permanente non è un'operazione una tantum. È un processo continuo che richiede attenzione e manutenzione. Ecco un approccio strutturato.
Fase 1: Audit iniziale
Prima di iniziare a costruire, verifica cosa l'assistente già sa di te. In Claude puoi chiedere direttamente "cosa ricordi di me?" e ottenere un riassunto del profilo in memoria. In ChatGPT puoi accedere alle impostazioni della memoria e vedere le informazioni salvate.
Questo audit ti dice due cose: quali informazioni sono già presenti (e magari obsolete o sbagliate) e quali gap esistono rispetto a quello che vorresti l'assistente sapesse.
Prendi nota delle correzioni necessarie e delle aggiunte da fare. Non cercare di fare tutto in una sessione - il sistema potrebbe non processare correttamente un carico eccessivo di informazioni nuove.
Fase 2: Onboarding strutturato
Una volta identificati i gap, procedi con un onboarding strutturato. L'approccio migliore è dedicare sessioni specifiche a "insegnare" all'assistente, separate dalle sessioni di lavoro normale.
In queste sessioni di onboarding, sii esplicito sulle tue intenzioni. Non limitarti a menzionare informazioni sperando che vengano registrate - chiedi esplicitamente che vengano memorizzate.
Per esempio: "Voglio che tu ricordi alcune informazioni sul mio lavoro che useremo nelle conversazioni future. Sono un consulente specializzato in [area]. I miei clienti principali sono [tipi di cliente]. I progetti tipici che seguo riguardano [ambiti]. Il mio approccio metodologico si basa su [principi]."
Dopo aver fornito un blocco di informazioni, verifica che siano state recepite. Puoi chiedere "riesci a riassumere cosa hai appena imparato su di me?" per confermare che l'assistente abbia processato correttamente.
Fase 3: Rinforzo durante il lavoro
L'onboarding iniziale non è sufficiente. La memoria permanente tende a "sbiadire" nel tempo se le informazioni non vengono rinforzate. Inoltre, il tuo contesto evolve - progetti che finiscono, nuovi che iniziano, metodologie che si affinano.
Durante il lavoro quotidiano, cogli le opportunità per rinforzare e aggiornare la memoria. Quando concludi un progetto, comunica esplicitamente che è terminato. Quando ne inizi uno nuovo, aggiungilo al contesto. Quando affini una metodologia, aggiorna la descrizione.
Non serve fare sessioni dedicate per ogni piccolo aggiornamento. Basta essere consapevoli che quello che dici può influenzare la memoria e usare formule esplicite quando qualcosa è importante: "Da oggi in poi…", "Voglio che tu ricordi che…", "Aggiorna il tuo contesto: il progetto X è concluso."
Fase 4: Manutenzione periodica
Almeno una volta al mese, fai un audit della memoria. Verifica cosa l'assistente ricorda e confrontalo con la realtà attuale. Rimuovi informazioni obsolete, correggi quelle sbagliate, aggiungi quelle mancanti.
Questa manutenzione è particolarmente importante se il tuo contesto cambia frequentemente. Un freelance che cambia clienti ogni pochi mesi ha bisogno di manutenzione più frequente di un dipendente con un ruolo stabile.
La manutenzione serve anche a identificare pattern. Se noti che certe informazioni non vengono mai registrate nonostante i tuoi sforzi, potrebbe essere necessario cambire il modo in cui le comunichi - renderle più esplicite, ripeterle più spesso, formularle diversamente.
Esempio pratico: costruire una memoria di progetto
Per rendere concreti questi principi, vediamo un esempio dettagliato. Immagina di essere un analista in una organizzazione internazionale che lavora su progetti di climate finance. Hai un progetto pluriennale che richiede coordinamento con multiple controparti, produzione di documenti tecnici, analisi di dati complessi.
Settimana 1: Fondamenta
Inizi con una sessione dedicata all'onboarding. Non stai lavorando - stai insegnando.
"Voglio configurarti per supportarmi su un progetto importante. Lavoro nel team di climate finance di [organizzazione]. Il mio ruolo è analista senior, responsabile di [funzioni specifiche]. Il progetto su cui ci concentreremo si chiama [nome], ha l'obiettivo di [obiettivo], coinvolge [controparti], e ha una durata prevista di [timeline].
I documenti principali che produrremo sono: country assessments, technical notes, policy briefs, presentazioni per il board. Ciascuno ha un formato specifico che ti spiegherò. I nostri interlocutori principali sono [tipi di stakeholder] e ciascuno richiede un linguaggio diverso."
Dopo questo onboarding iniziale, verifichi: "Riesci a riassumere cosa sai del progetto e del mio ruolo?"
Settimana 2-4: Costruzione incrementale
Durante il lavoro normale, ogni volta che definisci una convenzione o prendi una decisione metodologica importante, la rendi esplicita per la memoria.
"Ho definito la struttura standard per i country assessments. Ricorda: sezione 1 contesto macroeconomico, sezione 2 analisi delle vulnerabilità climatiche, sezione 3 mappatura degli strumenti finanziari esistenti, sezione 4 gap analysis, sezione 5 raccomandazioni. Ogni sezione non supera le 3 pagine. Le raccomandazioni sono sempre numerate e con indicazione di priorità."
"Abbiamo deciso la convenzione per i nomi dei file. Ricorda: formato [PAESE][TIPO_DOC][VERSIONE]_[DATA]. Tipo doc può essere CA per country assessment, TN per technical note, PB per policy brief. Versione è v01, v02 etc. Data in formato YYYYMMDD."
Queste micro-istruzioni, accumulate nel tempo, costruiscono un corpo di conoscenza procedurale che permette all'assistente di supportarti in modo sempre più preciso.
Mese 2+: Evoluzione e manutenzione
Man mano che il progetto avanza, la memoria deve evolversi. Quando completi il country assessment per il primo paese, aggiorni: "Il CA per [Paese 1] è completato e approvato. Ora stiamo lavorando su [Paese 2]. Il feedback ricevuto sul primo documento indica che dovremmo [lezione appresa]. Incorpora questo nelle prossime versioni."
Quando emergono nuovi pattern, li codifichi: "Ho notato che i reviewer chiedono sempre più dettagli sulla sezione 3. D'ora in poi quella sezione sarà più estesa - massimo 5 pagine invece di 3."
Quando il progetto finisce o cambia significativamente, fai pulizia: "Il progetto [nome] è concluso. Puoi archiviare quel contesto. Ora il focus è su [nuovo progetto]."
L'integrazione con la finestra di contesto
La memoria permanente non sostituisce la gestione della finestra di contesto - la complementa. Come abbiamo visto nel primo articolo, la finestra di contesto è lo spazio di lavoro della sessione corrente e ha limiti fissi.
La strategia ottimale usa entrambi i sistemi per quello che sanno fare meglio.
Memoria permanente: informazioni stabili, strutturali, metodologiche. Chi sei, come lavori, quali sono i tuoi progetti, quali standard applichi. Queste informazioni sono già presenti quando apri una nuova chat - non occupano spazio nel tuo primo messaggio.
Finestra di contesto: informazioni operative, specifiche della sessione. Il documento su cui stai lavorando, il problema specifico che stai risolvendo, le decisioni prese in questa sessione. Queste informazioni esistono solo per la durata della chat.
Briefing di passaggio: quando una sessione produce informazioni che devono persistere ma che non sono adatte alla memoria permanente (troppo dettagliate, troppo operative), crea un briefing come descritto nel primo articolo. Questo briefing lo salvi tu e lo reinserisci quando riprendi il lavoro.
L'errore comune è mettere troppe informazioni operative nella memoria permanente, saturandola di dettagli che cambiano continuamente. O, al contrario, non metterci nulla e dover ricostruire il contesto da zero in ogni sessione.
Gestire il ciclo di vita delle informazioni
Le informazioni hanno un ciclo di vita. Nascono, evolvono, diventano obsolete. La memoria permanente deve riflettere questo ciclo.
Informazioni a lungo termine
Alcune informazioni sono stabili per mesi o anni: il tuo ruolo professionale, le tue competenze core, le tue preferenze di comunicazione fondamentali. Queste vanno inserite una volta e verificate periodicamente per assicurarsi che siano ancora accurate.
Informazioni a medio termine
I progetti tipicamente durano da qualche mese a qualche anno. Mentre sono attivi, devono essere nella memoria. Quando finiscono, devono uscire - altrimenti ingombrano e creano confusione. Imposta un promemoria per rimuovere i progetti conclusi.
Informazioni a breve termine
Le attività specifiche, le deadline imminenti, le decisioni tattiche non appartengono alla memoria permanente. Cambiando troppo rapidamente, creerebbero più rumore che segnale. Queste vanno gestite nella finestra di contesto o in documentazione esterna.
Regola pratica
Se un'informazione sarà rilevante per più di un mese, valuta se inserirla nella memoria permanente. Se sarà rilevante per meno di una settimana, gestiscila nella sessione corrente. La zona grigia tra una settimana e un mese richiede giudizio caso per caso.
Quando la memoria diventa un problema
La memoria permanente non è sempre benefica. Ci sono situazioni in cui può ostacolare invece di aiutare.
Contesto sbagliato applicato automaticamente
Se chiedi aiuto su un argomento personale e l'assistente risponde con il tono e le assunzioni del tuo contesto professionale, la memoria sta interferendo. Questo accade perché il sistema non sempre distingue quando il contesto salvato è rilevante.
La soluzione è segnalare esplicitamente i cambi di contesto: "Questa domanda non riguarda il lavoro - è una questione personale su [tema]." Alcune piattaforme offrono anche la possibilità di sessioni "incognito" che non accedono alla memoria.
Informazioni obsolete che persistono
Hai cambiato lavoro sei mesi fa ma l'assistente continua a riferirsi al tuo ruolo precedente. Questo accade quando non hai fatto manutenzione della memoria dopo un cambiamento significativo.
La soluzione è un audit completo dopo ogni cambiamento importante nel tuo contesto - cambio di lavoro, cambio di progetto principale, cambio di metodologia. Non aspettare che le informazioni obsolete creino problemi.
Aspettative eccessive
Chiedi qualcosa che richiede informazioni specifiche che non hai mai condiviso, e ti aspetti che l'assistente le sappia. Questo crea frustrazione quando le risposte sono generiche o sbagliate.
La soluzione è avere aspettative realistiche su cosa la memoria può e non può contenere. Se un'informazione è importante, verifica che sia in memoria prima di assumere che l'assistente la conosca.
Privacy e controllo
Un aspetto che merita attenzione è il controllo sulle informazioni che condividi. La memoria permanente implica che dati su di te vengono salvati e processati al di fuori delle singole sessioni.
Ogni piattaforma ha politiche diverse. Alcune permettono di disabilitare completamente la memoria. Altre permettono di controllare cosa viene salvato e cosa no. Tutte dovrebbero permettere di cancellare i dati memorizzati.
Prima di iniziare a costruire una memoria ricca, verifica le politiche della piattaforma che usi. Comprendi cosa viene salvato, per quanto tempo, chi può accedervi, come puoi cancellarlo. Decidi consapevolmente quali informazioni sei disposto a condividere.
Per informazioni sensibili - dati personali di clienti, informazioni riservate, proprietà intellettuale - considera se la comodità della memoria permanente giustifica la condivisione. In molti casi la risposta è no, e queste informazioni vanno gestite nella finestra di contesto di sessioni specifiche, possibilmente in modalità incognito.
Strategie avanzate: template, flussi di lavoro e conoscenza procedurale
Una volta che la memoria di base è solida, puoi spingerti oltre. Le strategie avanzate riguardano la codifica di conoscenza procedurale - non solo cosa sai e su cosa lavori, ma come lavori.
Codificare i template
Se produci regolarmente documenti con struttura simile, codifica quella struttura nella memoria. Non limitarti a dire "faccio report mensili" - specifica la struttura esatta.
"I miei report mensili per il management hanno questa struttura: (1) Executive summary di massimo 200 parole con i 3 punti chiave, (2) Dashboard con 5 KPI sempre nello stesso ordine [elenco], (3) Analisi delle variazioni significative con threshold del 10%, (4) Rischi e criticità con classificazione rosso/giallo/verde, (5) Azioni proposte con owner e deadline, (6) Appendice dati solo se richiesta."
Con questa struttura in memoria, quando chiedi aiuto per il report mensile, l'assistente non propone un formato generico. Produce già una bozza allineata al tuo template.
Lo stesso vale per email, presentazioni, analisi. Ogni formato ricorrente che ha una struttura definita può essere codificato.
Codificare i flussi di lavoro
Oltre ai singoli output, puoi codificare i processi. Come affronti tipicamente certi tipi di problemi? Quali sono i passaggi che segui sempre?
"Quando devo analizzare un nuovo dataset: (1) prima esploro la struttura e la qualità dei dati, (2) poi identifico le variabili chiave e le relazioni attese, (3) poi faccio analisi descrittive di base, (4) poi passo a analisi più specifiche. Non salto mai i primi tre passaggi anche se il cliente ha fretta. Se ci sono problemi di qualità dei dati li segnalo prima di procedere."
Con questo flusso in memoria, quando chiedi supporto su un'analisi dati, l'assistente segue il tuo approccio metodologico invece di proporre un percorso generico.
Codificare le preferenze di tool e tecnologie
Se usi strumenti specifici, codificali. Questo evita che l'assistente suggerisca alternative che non puoi o non vuoi usare.
"Per analisi dati uso Python con pandas e matplotlib. Per presentazioni uso PowerPoint, mai Keynote. Per documenti uso Word con il template aziendale. Per project management usiamo Monday, non Asana o Jira. Per comunicazione interna Slack, per esterna email."
Questi vincoli sembrano banali ma evitano molti suggerimenti inutili.
Codificare le eccezioni e i casi particolari
Ogni metodologia ha eccezioni. Codificarle evita di doverle ricordare ogni volta.
"Normalmente i deliverable passano per review interna prima di andare al cliente, ma per aggiornamenti minori (correzioni typo, piccoli aggiustamenti di dati) posso mandare direttamente. La soglia è: se il cambiamento non modifica le conclusioni, posso procedere."
"I report per il cliente Gamma hanno un formato diverso dagli altri perché hanno richiesto specificamente [particolarità]. Quando lavoro per Gamma, usa quel formato, non quello standard."
Costruire librerie di riferimento
Puoi usare la memoria per indicare risorse che consulti frequentemente.
"Per domande su normativa GDPR faccio sempre riferimento al testo ufficiale del Regolamento e alle linee guida EDPB. Per standard di project management uso il PMBOK come riferimento principale. Per convenzioni di coding seguo PEP8 per Python."
Questo orienta l'assistente verso le fonti giuste quando cerca informazioni per te.
Casi d'uso avanzati: team, organizzazioni, progetti complessi
Fin qui abbiamo parlato di uso individuale. Ma la memoria permanente diventa ancora più potente in contesti strutturati.
Memoria condivisa per team
Alcune piattaforme permettono di creare "spazi" o "progetti" con memoria condivisa tra più utenti. In questi contesti, la memoria diventa conoscenza organizzativa invece che individuale.
Un team potrebbe codificare: le convenzioni del progetto, i ruoli di ciascun membro, le decisioni prese, gli standard di qualità, il glossario dei termini. Ogni membro del team interagisce con un assistente che conosce già il contesto condiviso.
Questo riduce drasticamente il tempo di onboarding per nuovi membri del team. Invece di spiegare tutto da zero, il nuovo arrivato trova un assistente già "formato" sul progetto.
Memoria di progetto persistente
Per progetti complessi e di lunga durata, puoi creare una memoria di progetto dedicata che evolve con il progetto stesso.
Nella fase iniziale contiene: obiettivi, stakeholder, vincoli, timeline di massima.
Nella fase di esecuzione si arricchisce di: decisioni prese, problemi incontrati, soluzioni adottate, lezioni apprese.
Nella fase finale documenta: risultati ottenuti, scostamenti dal piano, raccomandazioni per progetti futuri.
Questa memoria diventa una knowledge base del progetto accessibile a chiunque ci lavori.
Integrazione con documentazione esterna
La memoria permanente ha limiti di dimensione. Per contesti molto ricchi, la strategia è usare la memoria come "indice" che punta a documentazione esterna.
"La documentazione completa del progetto è in [posizione]. Il piano di progetto aggiornato è [documento]. Le specifiche tecniche sono [documento]. Quando lavoriamo su questo progetto, ti fornirò i documenti rilevanti all'inizio della sessione."
In questo modo la memoria sa che la documentazione esiste e dove trovarla, ma non cerca di contenerla tutta.
Misurare l'efficacia della memoria
Come sai se la tua strategia di memoria sta funzionando? Alcuni indicatori pratici.
Riduzione delle domande di contesto
Se l'assistente ti chiede meno spesso "in che contesto lavori?", "qual è il tuo ruolo?", "come preferisci che formatti la risposta?", la memoria sta funzionando. Tieni traccia mentalmente di quante volte devi fornire contesto che dovrebbe essere già noto.
Qualità del primo output
Quando chiedi di produrre qualcosa - una bozza di email, una struttura di presentazione, un'analisi - il primo tentativo è già vicino a quello che vuoi? O devi fare molte iterazioni di correzione? Una buona memoria riduce il numero di iterazioni necessarie.
Coerenza tra sessioni
Se apri chat diverse sullo stesso argomento, le risposte sono coerenti? L'assistente applica gli stessi standard e le stesse convenzioni? L'incoerenza è segnale che la memoria non sta funzionando correttamente.
Tempo risparmiato
Il test definitivo è quantitativo. Stai risparmiando tempo rispetto a prima? Il tempo investito nella costruzione della memoria sta producendo un ritorno? Se dopo un mese di uso strutturato non noti differenze, qualcosa non sta funzionando.
Errori comuni e come evitarli
Concludiamo con gli errori più frequenti nella gestione della memoria permanente.
Errore 1: Aspettarsi che funzioni da sola
Il sistema automatico cattura alcune informazioni, ma non è affidabile per quello che conta davvero. Se qualcosa è importante, rendilo esplicito. Non assumere che l'assistente "abbia capito" solo perché ne avete parlato.
Errore 2: Inserire troppo
La memoria ha limiti. Se cerchi di metterci tutto, niente avrà rilevanza. Sii selettivo. Meglio poche informazioni cruciali che un'enciclopedia di dettagli.
Errore 3: Non fare manutenzione
La memoria obsoleta è peggio di nessuna memoria. Crea confusione, genera risposte sbagliate, spreca spazio. Programma audit regolari.
Errore 4: Ignorare le differenze tra piattaforme
Ogni piattaforma implementa la memoria diversamente. Le strategie che funzionano su una potrebbero non funzionare su un'altra. Conosci le specificità del sistema che usi.
Errore 5: Confondere memoria permanente e finestra di contesto
Sono sistemi diversi con scopi diversi. Mettere informazioni operative nella memoria permanente la satura. Non mettere informazioni strutturali nella memoria la sottoutilizza. Usa ciascun sistema per quello che sa fare meglio.
Verso un assistente davvero personalizzato
L'obiettivo finale di una memoria permanente ben costruita è avere un assistente che ti conosce come ti conoscerebbe un collaboratore di lunga data. Che capisce il tuo contesto senza doverlo rispiegare. Che applica i tuoi standard senza doverli ricordare. Che sa quali sono i tuoi progetti attivi e quali sono finiti.
Questo non accade automaticamente. Richiede investimento iniziale nell'onboarding, disciplina nel mantenere la memoria aggiornata, consapevolezza dei limiti del sistema.
Ma il ritorno sull'investimento è significativo. Meno tempo speso a ricostruire contesto. Risposte più precise e pertinenti. Meno frustrazione per output generici che non rispettano i tuoi standard. Un'esperienza di lavoro con l'assistente che migliora progressivamente invece di restare sempre allo stesso livello.
La memoria permanente è uno degli strumenti meno sfruttati nell'uso quotidiano degli assistenti IA. La maggior parte delle persone la ignora completamente, ottenendo un servizio generico quando potrebbe avere un servizio personalizzato. Prenderne il controllo richiede un po' di lavoro iniziale, ma trasforma radicalmente l'utilità dell'assistente.
Box tecnico: cosa succede davvero nel sistema
Per chi vuole capire i meccanismi sottostanti, ecco una descrizione più tecnica di come funziona la memoria permanente.
Generazione del profilo. Le modalità dipendono dalla piattaforma: in alcuni casi le voci di memoria vengono costruite e aggiornate in tempo reale durante le conversazioni, in altri un sistema separato, che opera in background, analizza periodicamente le chat passate. In entrambi i casi il sistema usa tecniche di estrazione di informazioni e sintesi per identificare fatti salienti: chi sei, cosa fai, quali sono le tue preferenze. Questi fatti vengono aggregati in un profilo strutturato.
Iniezione nel contesto. Quando inizi una nuova conversazione, il profilo viene inserito all'inizio del prompt, prima ancora che tu scriva il primo messaggio. L'assistente lo "legge" come parte delle sue istruzioni iniziali. Da qui l'impressione che "ti conosca già" - in realtà sta leggendo un briefing preparato in anticipo.
Limiti di dimensione. Il profilo ha un limite massimo di dimensione per non occupare troppo spazio nella finestra di contesto. Questo limite varia per piattaforma ma tipicamente equivale a qualche centinaio o migliaio di parole. Non è molto, il che spiega perché le informazioni devono essere sintetiche e perché i dettagli operativi non sopravvivono.
Latenza di aggiornamento. Il tempo che passa tra quando dici qualcosa in una chat e quando quell'informazione compare nel profilo dipende dalla piattaforma: dove le voci vengono aggiornate in tempo reale è pressoché immediato, altrove può servire più tempo. In caso di dubbio, verifica il pannello Memoria della piattaforma che usi.
Persistenza e cancellazione. Il profilo persiste finché non lo modifichi esplicitamente o finché il sistema non lo rigenera scartando informazioni vecchie. Se cancelli conversazioni, le informazioni derivate vengono rimosse nella successiva rigenerazione del profilo - non istantaneamente.
Differenze tra piattaforme. ChatGPT permette di vedere e correggere i ricordi e la sintesi della memoria, oltre a usare una chat temporanea. Claude organizza la memoria in voci e categorie, mantiene spazi separati per i progetti e offre controlli di pausa, reset, importazione ed esportazione; la memoria non è attualmente disponibile in Cowork. Gemini e gli altri assistenti adottano logiche proprie. Le funzionalità cambiano rapidamente: prima di affidare informazioni importanti a una memoria automatica, verifica sempre la documentazione e i controlli della piattaforma che usi.
Memory edits vs. memoria derivata. Alcune piattaforme distinguono tra informazioni che tu inserisci esplicitamente (memory edits) e informazioni che il sistema deriva dalle conversazioni (memoria automatica). Le prime hanno precedenza e persistono in modo più affidabile. Se qualcosa è importante, vale la pena inserirlo come edit esplicito invece di sperare che venga derivato automaticamente.