Come usare gli LLM

Quando l'intelligenza artificiale inizia a dimenticare: come riconoscere una chat satura e cosa fare

Capire i limiti della finestra di contesto per lavorare meglio con gli assistenti IA

Pubblicato il 5 gennaio 20264 minuti di lettura
Quando l'intelligenza artificiale inizia a dimenticare: come riconoscere una chat satura e cosa fare
finestra di contestoChatGPTClaudememoriaprompt engineeringassistenti IA
Questo tema nel libroParte II - Come usare gli LLM3 capitoli: apri la sintesi e leggi come iniziano

Questa parte spiega come ottenere quello che ti serve da una chat, cosa cambia quando il modello diventa un agente e come riconoscere i tre modi in cui un modello sbaglia: invenzione, compiacenza, errore di calcolo.

I capitoli di questa parte

  • Capitolo 5 · pagina 95Ottenere quello che ti servePrompt engineering: come parlare ai modelli · Quando la chat si satura · La memoria degli LLM · Come far sì che l’IA si ricordi di te

    Il modello non impara niente mentre gli parli: i suoi pesi sono stati fissati mesi prima e restano fermi per tutta la conversazione. Quello che separa una risposta generica da una calibrata su di te sta in ciò che gli metti davanti e nel modo in cui glielo chiedi. Il capitolo racconta le tre cose che dipendono da te, e alla terza dedica due sezioni. La prima è la richiesta. Dare al modello un ruolo, spiegargli il contesto, dirgli in che formato vuoi la risposta, che cosa deve fare e che cosa no, cambia il risultato più di un cambio di modello; e due o tre esempi di quello che intendi valgono più di una lunga spiegazione. La seconda è accorgersi quando una conversazione è diventata troppo lunga e il modello comincia a perdere lucidità: l’assistente chiede cose che gli avevi già detto, o contraddice una decisione presa poco prima. Succede perché i messaggi più vecchi sono usciti dalla finestra di contesto, e accanirsi rispiegando ogni volta l’errore non serve. Il rimedio è chiedergli un passaggio di consegne e ripartire in una chat nuova. La terza è la memoria. Un chatbot ricorda per cinque vie diverse: quello che ha imparato in addestramento, che è come il suo DNA; la conversazione che ha davanti; un profilo su di te che il prodotto gli passa all’inizio di ogni chat; i materiali di un progetto; e gli strumenti con cui va a cercare le informazioni che gli servono. Conoscere le caratteristiche e i limiti di questi cinque tipi di memoria cambia molto l’esperienza d’uso.

    Perché leggerlo: sono le competenze che rendono da subito, su una chat qualunque, senza comprare niente, e sono il presupposto dei due capitoli che seguono. Leggilo per intero e con la chat aperta: ogni tecnica si prova in trenta secondi su una conversazione tua.

  • Capitolo 6 · pagina 103Dall’assistente all’agenteChe cosa si intende per “Agentic AI” · I quattro pilastri dell’Agentic AI · Sfide dell’Agentic AI: autonomia, sicurezza e responsabilità · Controllare gli agenti: architetture, limiti e supervisione · Dagli agenti episodici agli agenti long-running · L’attenzione come risorsa scarsa: i sistemi multi-agente · Chi costruisce gli agenti, e con quale idea

    Un agente fa la cosa di cui un modello ti parla soltanto. Se chiedi a un modello un’email di ringraziamento, ottieni il testo; se la chiedi a un agente, ti apre la posta, compila il destinatario e la manda. Il capitolo spiega che cosa permette al modello di avere questa autonomia e come si tiene sotto controllo. Il meccanismo è più semplice di quanto il marketing lasci intendere: un agente è un modello che usa strumenti dentro un ciclo. Riceve un obiettivo, compie un’azione, legge il risultato, decide la mossa successiva, e si ferma quando l’obiettivo è raggiunto o quando finiscono i tentativi. Quattro cose distinguono un vero agente da una chat con qualche funzione in più: una memoria che dura oltre la singola conversazione, la capacità di pianificare una sequenza di passi, l’uso di strumenti esterni e un’autonomia controllata, cioè confini entro cui può agire da solo e punti in cui deve chiedere. C’è però un’avvertenza. Gli agenti rendono dove qualcuno può giudicare ogni passo, come i test nel codice; altrove gli errori si accumulano in silenzio, e un passo sbagliato diventa la premessa di quello dopo. Per questo il controllo si distribuisce su quattro livelli, dai dati a cui l’agente può accedere fino alla persona che approva. Il capitolo si chiude con due frontiere: gli agenti che lavorano per giorni, che hanno bisogno di una memoria del lavoro in corso che i prodotti di oggi ancora non danno, e i sistemi in cui più agenti si dividono il compito, perché l’attenzione di uno solo non basta.

    Perché leggerlo: la delega a un agente è una delle cose che il libro promette di farti saper fare, e questo capitolo dice che cosa stai delegando quando la fai. Le sezioni sul ciclo, sui quattro pilastri, sulle sfide e sul controllo servono per seguire il capitolo sul ridisegno del lavoro. Le due sull’orizzonte, gli agenti che lavorano per giorni e i sistemi di più agenti, si possono rimandare senza perdere il filo; l’ultima, su chi li costruisce, si legge quando ti serve un nome.

  • Capitolo 7 · pagina 117Quando il modello sbagliaQuando l’IA inventa: il problema delle allucinazioni · Quando l’IA ti dà ragione: la sicofanzia · Quando l’IA fa i conti: un problema di significato

    Una risposta sbagliata arriva con lo stesso tono di una giusta, nella stessa forma ordinata, nello stesso mezzo secondo. Non c’è un’esitazione che la distingua: te ne accorgi dopo, quando qualcuno controlla un numero o apre una fonte che non esiste. Il capitolo racconta tre modi in cui un modello può sbagliare. Si somigliano nell’aspetto, ma richiedono controlli diversi. Il primo è l’invenzione: il modello afferma qualcosa che non esiste, una sentenza, un articolo di legge, una citazione. Succede perché il modello non consulta un archivio: prevede la continuazione più probabile del testo, e quando su un argomento ha visto poco produce qualcosa che ha l’aspetto di un fatto. Il rischio sale in quattro situazioni riconoscibili: i riferimenti, i fatti rari, i numeri che nessuno ha mai pubblicato e il dettaglio falso dentro una risposta per il resto giusta. Il secondo è la compiacenza: il modello ti dà ragione anche quando hai torto, perché ha imparato che la risposta compiacente è quella che preferisci. Nasce dall’addestramento, dove le persone premiano le risposte in linea con le loro aspettative, e continua nell’uso; per questo “sei sicuro?” è il controllo meno affidabile di tutti. Il terzo è l’errore di calcolo: i dati sono veri e l’operazione è sbagliata, per esempio somma le percentuali o fa la media delle medie, e un numero sbagliato ha la stessa faccia di uno giusto. Per ciascuno dei tre il capitolo dà un controllo che costa poco: verificare che la fonte esista prima di leggere che cosa dice, e chiedere se un numero è un dato o una stima; far difendere al modello la sua risposta prima di cambiarla; far scrivere il calcolo in una forma che si possa rieseguire. La regola generale è una sola: il tono con cui il modello risponde non dice niente sulla sua accuratezza.

    Perché leggerlo: è il capitolo della seconda promessa, e il più utile da solo: vale per la chat, per l’agente e per qualunque sistema della parte aziendale. Va letto tutto, e le tre sezioni in ordine, perché il controllo istintivo contro il primo errore innesca il secondo. Se di questo libro leggi tre capitoli, questo è uno dei tre.

Il libro costruisce le basi in modo progressivo; gli articoli approfondiscono e aggiornano i singoli temi man mano che cambiano.

Stai lavorando a un progetto con ChatGPT, Claude o un altro assistente IA. La conversazione va avanti da un po', avete stabilito convenzioni, preso decisioni, costruito qualcosa insieme. A un certo punto noti qualcosa di strano: l'assistente ti chiede un'informazione che gli avevi già dato. Oppure fa qualcosa che contraddice una decisione presa mezz'ora prima. Sembra aver perso il filo.

Non è un bug. È il funzionamento normale di questi sistemi, e capirlo ti permette di lavorarci meglio.

Come funziona davvero la "memoria" di una chat

Quando chatti con un assistente IA, potresti immaginare che ricordi la conversazione come faresti tu. In realtà, a ogni turno il sistema ricostruisce un contesto operativo usando i messaggi ancora disponibili, le istruzioni, gli eventuali file e — in alcune piattaforme — sintesi o recuperi selettivi di parti precedenti.

Lo spazio resta finito: si chiama finestra di contesto ed è come una scrivania su cui può stare solo un certo numero di fogli. Quando il materiale cresce troppo, la piattaforma può escludere, riassumere o compattare le parti più vecchie. Inoltre, la qualità può degradare anche prima del limite: un'informazione importante può essere presente ma ricevere meno attenzione perché circondata da molto rumore.

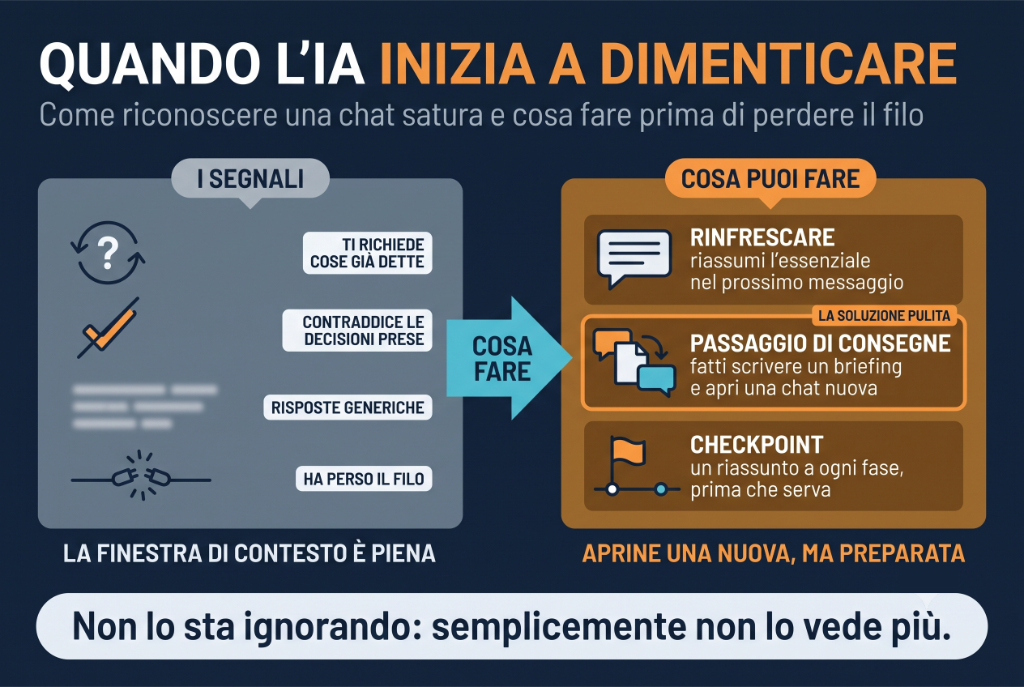
Perciò “ha perso il filo” non significa sempre che un messaggio sia semplicemente scomparso. Può dipendere da troncamento, sintesi imperfetta, istruzioni in conflitto o difficoltà nel recuperare il dettaglio giusto dentro un contesto molto lungo.

Come accorgersi che la chat si sta saturando

I segnali sono abbastanza riconoscibili una volta che sai cosa cercare.

Il più evidente è quando l'assistente ti chiede qualcosa che gli avevi già spiegato. Se all'inizio della conversazione avevi detto "lavoro su file Excel, non CSV" e due ore dopo ti propone una soluzione basata su CSV, probabilmente quel messaggio iniziale è uscito dalla finestra di contesto.

Un altro segnale è l'incoerenza con decisioni prese insieme. Avevate concordato uno stile, un formato, un approccio — e improvvisamente le risposte non lo rispettano più, senza che tu abbia chiesto di cambiare.

A volte è più sottile: l'assistente sembra rispondere in modo generico a domande che richiederebbero il contesto specifico della vostra conversazione. Le risposte diventano meno precise, meno "su misura".

In generale, se hai la sensazione che l'assistente abbia perso il filo del discorso, probabilmente è esattamente quello che è successo.

Cosa fare quando la chat è satura

Hai due opzioni: tentare di rinfrescare il contesto nella chat corrente, oppure ricominciare da capo in una chat nuova.

Rinfrescare il contesto significa riassumere brevemente le informazioni essenziali nel tuo prossimo messaggio. Qualcosa come: "Ti ricordo che stiamo lavorando su X, abbiamo deciso di usare l'approccio Y, e il file si chiama Z. Detto questo, procediamo con..." Funziona per situazioni semplici, ma stai comunque aggiungendo testo a una finestra già piena.

La soluzione più pulita è aprire una chat nuova. Ma prima di farlo, chiedi all'assistente di prepararti un passaggio di consegne. Un prompt efficace è:

"Devo continuare questo lavoro in una nuova chat. Prepara un briefing sintetico con: obiettivo del progetto, stato attuale, decisioni prese, prossimi passi, e informazioni che non devo perdere."

Quello che otterrai è un riassunto concentrato che puoi incollare all'inizio della nuova conversazione. Molto più efficiente che copiare l'intera cronologia — cosa che riempirebbe subito la nuova finestra di contesto con materiale vecchio, spostando il problema invece di risolverlo.

Prevenire è meglio che curare

Se stai lavorando a qualcosa di complesso, non aspettare che la chat si saturi. Ogni tanto — ad esempio quando completi una fase del lavoro — chiedi all'assistente di generare un "checkpoint": un riassunto dello stato attuale che puoi salvare e riutilizzare se necessario.

Può anche essere utile tenere conversazioni separate per progetti diversi. Mescolare argomenti non correlati nella stessa chat la fa saturare più in fretta e rende difficile riprendere il filo di un singolo filone.

Infine, ricorda che la chat serve per ragionare insieme, non per archiviare. Tutto ciò che è tangibile — documenti, codice, liste, decisioni importanti — va salvato fuori, sul tuo computer o in cloud. Se la chat sparisce o si satura, il lavoro vero deve essere al sicuro altrove.


Box tecnico: la memoria tra le chat

Se usi regolarmente uno di questi assistenti, potresti aver notato che alcune informazioni su di te persistono anche quando inizi una conversazione nuova: non devi rispiegare ogni volta chi sei o su cosa lavori.

Questo avviene grazie a un sistema separato dalla finestra di contesto. I principali servizi — ChatGPT, Claude, Gemini — analizzano le tue conversazioni passate per estrarne informazioni chiave: chi sei, su cosa lavori, come preferisci comunicare. Queste sintesi vengono salvate e richiamate automaticamente nelle chat successive.

È importante capire cosa fa e cosa non fa questa memoria. Sa che lavori nel settore X e che stai seguendo il progetto Y. Ma non ricorda i dettagli operativi della sessione di ieri: quale file stavate modificando, quale problema avete risolto, quali decisioni avete preso al volo. Per quelli serve il contesto della singola chat — o il briefing di passaggio consegne quando ne apri una nuova.

Resta aggiornato

Un solo aggiornamento per articoli, eventi e nuove edizioni

Nuovi articoli sull'IA
Nuove edizioni del libro ed eventi