Quando si parla di Retrieval-Augmented Generation (RAG), la definizione più diffusa è apparentemente semplice: un modello linguistico viene affiancato a una base documentale esterna, dalla quale recupera le informazioni rilevanti al momento della domanda. In questo modo il modello non risponde solo in base a ciò che ha appreso durante l'addestramento, ma utilizza documenti specifici, aggiornabili e verificabili.
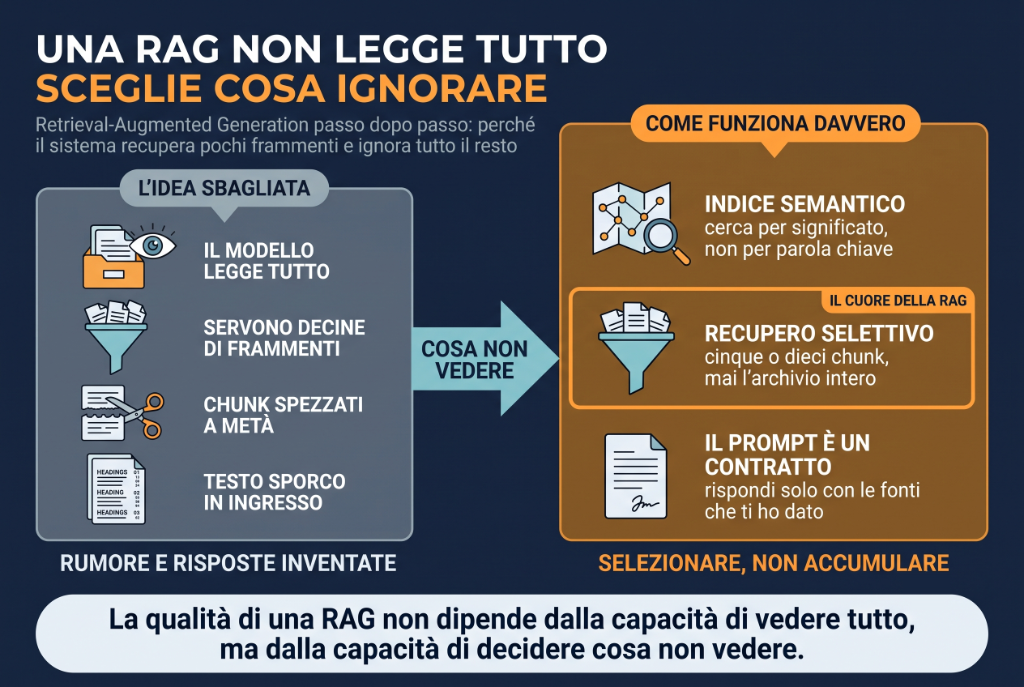
Questa descrizione, però, rischia di essere fuorviante se presa alla lettera. Una RAG non è un sistema che "legge tutti i documenti" prima di rispondere, né un meccanismo che rende il modello onnisciente. Al contrario, il suo funzionamento si basa su una scelta radicale e controintuitiva: per ogni domanda, il sistema seleziona pochissimi frammenti di testo e ignora deliberatamente tutto il resto.
Capire perché questa scelta funziona, e quali condizioni devono essere soddisfatte perché produca buoni risultati, è essenziale per usare la RAG in modo consapevole.
Il principio chiave: selezionare, non accumulare
Il cuore della RAG è la selettività. Anche quando la base documentale è composta da migliaia di file, il sistema non cerca di tenerne conto nel loro insieme. Per ogni domanda recupera in genere un numero molto limitato di frammenti testuali, tipicamente tra cinque e dieci chunk. Questo numero non cresce con la dimensione dell'archivio, perché la domanda resta sempre locale: riguarda un aspetto specifico, che nella maggior parte dei casi è trattato in poche sezioni ben precise.
La qualità della RAG non dipende quindi dalla sua capacità di "vedere tutto", ma dalla sua capacità di decidere cosa non vedere. Tutto ciò che non è rilevante per quella domanda viene escluso dal contesto fornito al modello, riducendo rumore, ambiguità e rischio di risposte inventate.
Dalla base documentale al testo utilizzabile
Il funzionamento della RAG inizia molto prima della prima domanda dell'utente. La fase iniziale è spesso la più sottovalutata, ma anche una delle più determinanti.
I documenti di partenza possono essere eterogenei: PDF nativi, PDF scansionati, file Word, presentazioni, pagine HTML, email, allegati tecnici. Prima di qualsiasi operazione semantica, questi contenuti devono essere trasformati in testo. Questo passaggio include, quando necessario, il riconoscimento ottico dei caratteri, l'estrazione delle tabelle, la gestione delle immagini contenenti testo.
Una volta estratto il testo, è necessaria una fase di pulizia. In questa fase si eliminano o si normalizzano elementi che disturbano la comprensione e la ricerca semantica: intestazioni ripetute su ogni pagina, numeri di pagina, note marginali, riferimenti incrociati spezzati, spaziature anomale. Quando possibile, si preserva invece la struttura logica del documento, mantenendo titoli, sottotitoli, paragrafi e sezioni. Questa struttura sarà preziosa nelle fasi successive.
La pulizia non serve a "abbellire" i dati, ma a rendere il testo semanticamente coerente. Un sistema RAG non può compensare un input testuale confuso o rumoroso: se l'informazione è distorta a monte, anche il retrieval lo sarà.
Il chunking: spezzare senza distruggere il significato
Dopo la pulizia, i documenti vengono suddivisi in chunk, ovvero frammenti di testo di dimensione controllata. Questo passaggio è necessario perché né la ricerca semantica né il modello linguistico lavorano bene su documenti molto lunghi presi nel loro insieme.
Il chunking efficace non è una semplice divisione meccanica ogni N parole. L'obiettivo è creare frammenti che siano informativamente densi e autosufficienti, ciascuno dei quali rappresenti un'idea completa o un sotto-argomento coerente. In genere si lavora con dimensioni dell'ordine di alcune centinaia di parole, spesso con una leggera sovrapposizione tra chunk consecutivi per evitare di spezzare concetti a metà.
Un chunk ben progettato deve poter essere compreso anche se letto isolatamente. Se per capirlo è necessario leggere dieci pagine precedenti, quel chunk non funzionerà bene in un sistema RAG.
Embedding e indicizzazione: trasformare il testo in spazio semantico
Ogni chunk viene poi trasformato in un embedding, cioè in una rappresentazione numerica che cattura il significato del testo. Chunk semanticamente simili finiscono vicini in questo spazio, anche se utilizzano vocaboli diversi.
Gli embedding vengono memorizzati in un indice vettoriale insieme al testo originale e ai metadati: documento di provenienza, sezione, pagina, data, eventuale categoria. Questo indice è il vero motore di ricerca della RAG. Non serve a recuperare testi per parola chiave, ma a individuare frammenti concettualmente affini a una domanda.
A questo punto la base documentale è pronta. Nulla è ancora stato passato al modello, ma il sistema ha costruito una mappa semantica del corpus.
La domanda dell'utente e la riscrittura della query
Quando l'utente pone una domanda, il sistema non si limita sempre a usarla così com'è. Le domande reali sono spesso brevi, implicite o ambigue. Per migliorare la qualità del retrieval, una RAG matura utilizza una fase di riscrittura della query, in cui la domanda viene espansa e resa più esplicita.
Questa riscrittura non aggiunge conoscenza, ma chiarisce il contesto e gli elementi rilevanti, aumentando la probabilità che i chunk giusti emergano dalla ricerca semantica.
La query riscritta viene a sua volta trasformata in embedding e confrontata con tutti i chunk indicizzati.
Il retrieval: pochi chunk, scelti con cura
Il confronto tra embedding della query ed embedding dei chunk produce una lista di frammenti semanticamente vicini. Da questa lista vengono selezionati solo i migliori, in genere un numero limitato. Nella pratica operativa, valori compresi tra cinque e dieci chunk rappresentano uno standard molto diffuso.
Questo passaggio è spesso seguito da un'ulteriore selezione, detta reranking, che valuta più finemente la pertinenza dei chunk rispetto alla domanda. Il risultato finale è un insieme ristretto di frammenti che contengono, con buona probabilità, l'informazione cercata.
Tutto il resto dell'archivio viene ignorato. Non perché sia inutile in assoluto, ma perché non è rilevante per quella domanda specifica.
Dal retrieval alla generazione: il ruolo del prompt
I chunk selezionati vengono inseriti nel prompt insieme alla domanda dell'utente e a istruzioni precise su come il modello deve comportarsi. È in questa fase che si definisce il "contratto" operativo: rispondere solo usando le fonti fornite, segnalare esplicitamente l'assenza di informazioni, evitare deduzioni non supportate, citare le fonti quando richiesto.
Il modello non ha accesso diretto all'indice vettoriale né all'intera base documentale. Per lui esiste solo ciò che è presente nel prompt. La qualità della risposta dipende quindi direttamente dalla qualità del retrieval e dalla chiarezza delle istruzioni.
Perché la RAG funziona anche su archivi enormi
Il fatto che una RAG utilizzi solo pochi chunk non è una debolezza, ma una conseguenza della natura delle domande. Anche in archivi molto grandi, le informazioni operative, normative o tecniche sono concentrate in punti specifici. La RAG sfrutta questa concentrazione, isolando rapidamente le parti rilevanti.
Quando un sistema sembra aver bisogno di decine di chunk per rispondere, il problema raramente è il numero in sé. Più spesso è sintomo di chunking inefficace, pulizia insufficiente dei dati, query troppo vaghe o assenza di meccanismi di selezione più raffinati.
I limiti della RAG semplice e il caso dei documenti complessi
La RAG descritta fin qui è progettata per rispondere a una domanda. Se l'obiettivo è costruire un documento lungo e articolato, basato su molte fonti, questo approccio non è sufficiente.
In questi casi, la RAG va usata come un componente di un processo più ampio. Il documento viene prima scomposto concettualmente in sezioni. Ogni sezione diventa una domanda autonoma, per la quale la RAG recupera i chunk pertinenti e genera un testo locale coerente. Questi testi intermedi vengono poi integrati e armonizzati in un secondo momento.
In questo modo, la RAG continua a lavorare su contesti limitati e controllabili, mentre il documento finale emerge da una sequenza di passi ben orchestrati, non da un singolo prompt sovradimensionato.
RAG e agenti: quando il retrieval diventa uno strumento
Finora la RAG è stata descritta come un flusso relativamente lineare: una domanda, il recupero di alcuni chunk rilevanti, la generazione di una risposta. Questo schema è efficace per molte applicazioni, ma mostra i suoi limiti quando le richieste diventano più complesse, articolate o orientate alla produzione di documenti strutturati.
Nei sistemi agentici, la RAG non è più il sistema in sé, ma uno strumento a disposizione di un agente. L'agente — che può essere un LLM con capacità di pianificazione e uso di strumenti — decide quando e come invocare la RAG, in base allo stato del compito che sta svolgendo.
In un flusso agentico tipico, l'agente riceve un obiettivo complesso, lo scompone in sotto-problemi, e per ciascuno di essi decide se ha già le informazioni necessarie o se è opportuno effettuare una ricerca sulla base documentale. La RAG viene quindi invocata selettivamente, come si consulterebbe un archivio specifico solo quando serve.
Questo approccio combina la flessibilità del ragionamento agentico con la precisione del retrieval semantico, permettendo di affrontare compiti che nessuno dei due componenti potrebbe gestire da solo.
Conclusione
La RAG è una tecnologia potente, ma la sua efficacia dipende interamente dalla qualità di ogni fase del processo: dalla pulizia dei dati al chunking, dall'embedding al retrieval, fino alla costruzione del prompt. Non esiste una RAG "di default" che funziona bene su qualsiasi corpus e per qualsiasi tipo di domanda.
Comprendere come funziona davvero — e soprattutto capire il principio di selettività che ne è al cuore — è il primo passo per usarla in modo consapevole e per diagnosticare correttamente i problemi quando i risultati non sono quelli attesi.