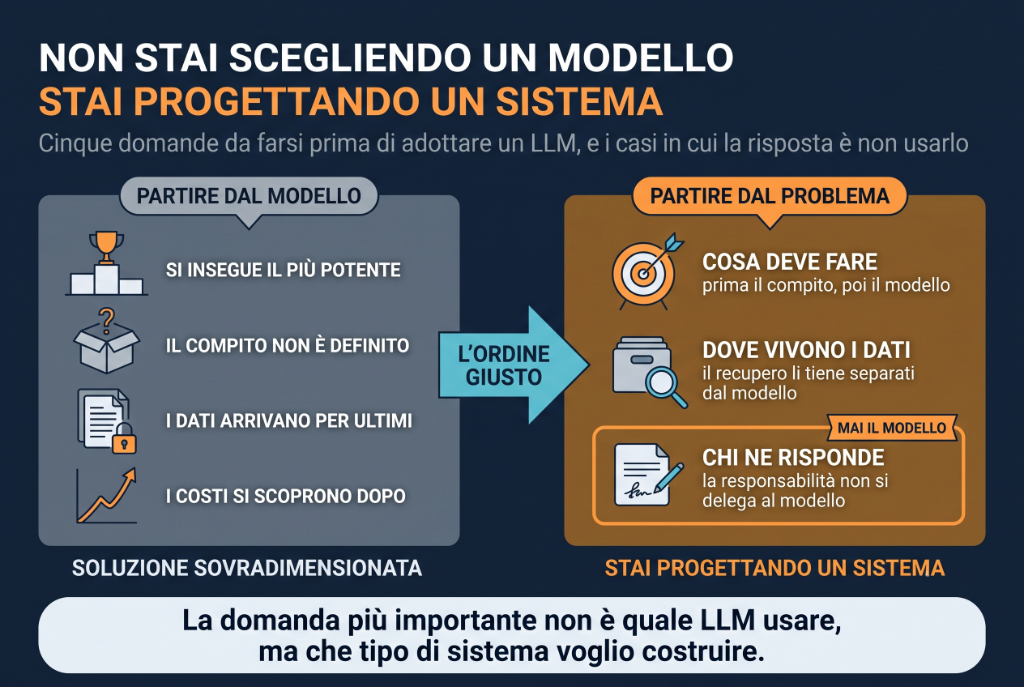
Negli ultimi anni i Large Language Models sono entrati rapidamente nel dibattito pubblico e professionale. Per molti, "usare un LLM" significa semplicemente collegarsi a un'interfaccia di chat e iniziare a fare domande. In realtà, quando si passa dall'uso individuale alla progettazione di una soluzione – in un'azienda, in una scuola, in una pubblica amministrazione o in un progetto strutturato – la questione diventa molto più complessa.
Scegliere una soluzione basata su LLM non è una decisione puramente tecnologica. Non consiste nel selezionare il modello più potente, il più grande o il più pubblicizzato del momento. È una scelta che coinvolge obiettivi, dati, costi, rischi, vincoli organizzativi e responsabilità. Lo stesso modello può produrre risultati eccellenti in un contesto e rivelarsi inadeguato in un altro.
Questo articolo nasce da una constatazione semplice: molte difficoltà nell'adozione degli LLM non derivano dai limiti intrinseci dei modelli, ma da aspettative mal poste e da scelte iniziali sbagliate. Spesso si parte dal modello, quando invece bisognerebbe partire dal problema. Si parla di prestazioni e parametri, ma non ci si interroga abbastanza su cosa il sistema debba realmente fare, su quali dati debba usare e su quale ruolo debba avere all'interno di un processo più ampio.
L'obiettivo di questo contributo non è fornire una guida tecnica né una classifica dei migliori LLM disponibili. L'intento è piuttosto quello di offrire una griglia di lettura, una serie di domande fondamentali che aiutino a orientarsi nella scelta della soluzione più adatta a uno specifico contesto. Capire quando ha senso usare un modello via API, quando puntare su soluzioni open source, quando costruire un sistema ibrido, e quando, semplicemente, un LLM non è lo strumento giusto.
In altre parole, parleremo meno di modelli e più di sistemi. Perché, nella pratica, il valore non nasce dal modello in sé, ma da come viene integrato, governato e utilizzato all'interno di un progetto concreto.
La prima domanda: cosa deve fare davvero il sistema?
Prima di chiedersi quale modello utilizzare, quale fornitore scegliere o quale infrastruttura predisporre, è necessario fermarsi su una domanda più semplice solo in apparenza: che cosa deve fare davvero il sistema che sto progettando?
Questa domanda vale allo stesso modo per un libero professionista che vuole migliorare il proprio lavoro quotidiano, per un'impresa che intende introdurre l'intelligenza artificiale nei propri processi, e per una pubblica amministrazione che valuta nuovi strumenti di supporto alle decisioni o ai servizi ai cittadini. Cambiano le scale, i vincoli e le responsabilità, ma la logica di fondo resta identica.
Molti progetti partono dall'idea di "usare un LLM" senza aver chiarito il compito specifico che il sistema dovrà svolgere. Il risultato è spesso una soluzione sovradimensionata, costosa o semplicemente inefficace. In altri casi, al contrario, si chiede a un modello di linguaggio di risolvere problemi che non sono di natura linguistica, o che richiederebbero soprattutto accesso strutturato ai dati e regole chiare.
In termini pratici, è utile distinguere almeno quattro grandi tipologie di utilizzo.
La prima riguarda la generazione di contenuti. Scrittura di testi, sintesi di documenti, traduzioni, riformulazioni, adattamento del linguaggio a un certo pubblico. In questi casi il valore dell'LLM sta nella sua capacità di produrre linguaggio coerente e contestualmente adeguato. Il sistema può funzionare anche senza accedere a basi dati esterne complesse, purché il perimetro del compito sia ben definito.
La seconda tipologia è il supporto cognitivo basato su informazioni esistenti. Qui l'LLM non è chiamato tanto a "creare", quanto ad aiutare a orientarsi in grandi quantità di contenuti: rispondere a domande su documenti, regolamenti, archivi, manuali, delibere, contratti. In questi casi il nodo centrale non è il modello in sé, ma il modo in cui il sistema recupera e fornisce al modello le informazioni rilevanti. È il classico scenario in cui entrano in gioco tecniche come il retrieval e l'uso di basi di conoscenza esterne.
La terza area riguarda l'automazione di compiti e processi. Qui l'LLM diventa un componente di un flusso più ampio: interpreta una richiesta, decide una sequenza di azioni, interagisce con altri sistemi, produce un output che attiva ulteriori passaggi. È un uso sempre più diffuso, ma anche più delicato, perché introduce il tema del controllo, degli errori e della responsabilità.
Infine, esistono casi di interazione continua, in cui il sistema deve mantenere una relazione nel tempo con l'utente: assistenti personali, supporto interno, sportelli digitali. In questi contesti entrano in gioco concetti come memoria, contesto persistente, coerenza delle risposte e gestione delle informazioni personali.
Questa distinzione non serve a classificare rigidamente i progetti, ma a chiarire un punto fondamentale: soluzioni diverse richiedono scelte diverse. Un LLM eccellente per la generazione di testi può essere inadeguato come supporto a decisioni operative. Un sistema efficace per interrogare documenti può risultare fragile se usato per automatizzare processi complessi.
Solo dopo aver chiarito quale ruolo deve avere il sistema – e quali limiti non deve superare – ha senso affrontare le domande successive: quali dati usare, dove farli risiedere, quale modello adottare e come governarne il comportamento.
La seconda domanda: quali dati servono e come devono essere gestiti?
Una volta chiarito cosa deve fare il sistema, la domanda successiva riguarda i dati. È un passaggio cruciale, spesso sottovalutato, perché determina in larga misura l'architettura della soluzione e le scelte successive sul modello.
Un LLM, da solo, non "conosce" i dati dell'utente, dell'organizzazione o del contesto specifico in cui viene utilizzato. La sua conoscenza è il risultato dell'addestramento iniziale e rimane, per definizione, generica. Ogni volta che si chiede al sistema di lavorare su informazioni specifiche – documenti interni, archivi, normative, dati aggiornati – si entra nel tema di come quei dati vengono messi a disposizione del modello.
La prima distinzione riguarda la natura dei dati. Possono essere pubblici o proprietari, strutturati o non strutturati, statici o in continuo aggiornamento. Un conto è interrogare un insieme di documenti che cambia raramente, un altro è lavorare su informazioni che evolvono ogni giorno o che dipendono da decisioni recenti. In questi casi, affidarsi esclusivamente alla "memoria" del modello non è solo inefficace, ma potenzialmente fuorviante.
C'è poi il tema della sensibilità. Dati personali, informazioni riservate, atti amministrativi, documentazione contrattuale o sanitaria impongono vincoli stringenti su dove i dati possano risiedere, su chi possa accedervi e su come vengano trattati. Questo vale per un professionista che gestisce informazioni dei propri clienti, per un'impresa che tutela il proprio know-how e, a maggior ragione, per una pubblica amministrazione.
In molti casi, la soluzione non consiste nel "caricare i dati nel modello", ma nel costruire un sistema che permetta al modello di accedere, di volta in volta, solo alle informazioni rilevanti. È qui che entrano in gioco architetture basate sul recupero delle informazioni, in cui il modello di linguaggio diventa uno strumento di interpretazione e sintesi, non un contenitore permanente di conoscenza.
Questa impostazione ha almeno tre vantaggi. Consente di lavorare su dati aggiornati senza dover riaddestrare il modello. Riduce il rischio di utilizzi impropri o di esposizione eccessiva delle informazioni. E permette di mantenere una chiara separazione tra il modello e i dati, facilitando il controllo e la governance del sistema.
La gestione dei dati, dunque, non è un aspetto tecnico da affrontare in un secondo momento, ma una scelta strategica che influenza tutto il resto: il tipo di modello utilizzabile, l'infrastruttura necessaria, i costi e i rischi accettabili. Solo avendo chiaro questo quadro ha senso passare alla domanda successiva: dove far girare il sistema e quale tipo di soluzione adottare.
La terza domanda: soluzione chiusa, open source o ibrida?
Arrivati a questo punto, la tentazione è quella di porre la domanda nel modo più diretto possibile: meglio usare un modello commerciale accessibile via API o puntare su una soluzione open source da gestire internamente? In realtà, questa contrapposizione rischia di essere fuorviante se non viene ricondotta al contesto definito nelle sezioni precedenti.
Non esiste una risposta universalmente valida. Le soluzioni basate su modelli chiusi offrono spesso un'elevata qualità delle risposte, aggiornamenti continui e una semplicità di utilizzo che le rende ideali per avviare rapidamente un progetto o per casi d'uso non critici. Per molti utenti individuali, professionisti o organizzazioni alle prime esperienze, rappresentano un punto di ingresso naturale.
Le soluzioni open source, al contrario, richiedono maggiore competenza tecnica e una gestione più attenta dell'infrastruttura, ma offrono un controllo molto più ampio. Consentono di decidere dove far risiedere i dati, come configurare il modello, come integrarlo con altri sistemi e come governarne l'evoluzione nel tempo. Questo approccio diventa particolarmente rilevante quando entrano in gioco vincoli normativi, esigenze di personalizzazione avanzata o requisiti stringenti di sicurezza.
Tra questi due estremi si colloca un numero crescente di soluzioni ibride. In questi casi, il modello di linguaggio può essere open source o proprietario, ma viene inserito in un'architettura che combina servizi gestiti, componenti interni e livelli di controllo differenziati. È una scelta sempre più frequente, perché consente di bilanciare rapidità di adozione e controllo, riducendo al tempo stesso i rischi di dipendenza da un singolo fornitore.
La distinzione, quindi, non va letta in termini ideologici, ma come una valutazione di compromessi. Semplicità contro controllo, velocità contro flessibilità, delega contro responsabilità. Un libero professionista, una piccola impresa o una pubblica amministrazione possono legittimamente arrivare a scelte diverse partendo dalle stesse domande di fondo.
Un indicatore utile è chiedersi quanto la soluzione debba essere stabile nel tempo. Se il sistema è pensato come strumento sperimentale o di supporto occasionale, la dipendenza da servizi esterni può essere accettabile. Se invece diventa un elemento strutturale di un processo, allora la capacità di governarne il funzionamento, i costi e l'evoluzione diventa un fattore decisivo.
Chiarire questo punto permette di evitare molte false alternative e prepara il terreno alla questione successiva, spesso scoperta solo in una fase avanzata del progetto: l'infrastruttura, i costi e la sostenibilità operativa della soluzione.
📦 Box tecnico – Modello, dati e infrastruttura: le combinazioni possibili
Quando si parla di "usare un LLM", spesso si immagina una soluzione unica e indistinta. In realtà, le architetture possibili sono molteplici e nascono dalla combinazione di tre elementi fondamentali: dove gira il modello, come accede ai dati e chi governa l'infrastruttura. Chiarire queste dimensioni aiuta a capire perché soluzioni apparentemente simili possano avere implicazioni molto diverse.
Dove gira il modello
Un primo discrimine riguarda il luogo in cui il modello di linguaggio viene eseguito.
Nel caso dei modelli accessibili via API, il modello gira su infrastruttura del fornitore. L'utente invia una richiesta e riceve una risposta, senza gestire direttamente hardware, aggiornamenti o pesi del modello. È un approccio semplice e immediato, che consente di accedere rapidamente a modelli molto potenti, ma comporta una dipendenza dal servizio esterno e un controllo limitato sugli aspetti infrastrutturali.
Nel caso dei modelli on-premise o self-hosted, il modello viene eseguito su server sotto il controllo diretto dell'utente, che possono trovarsi in un data center aziendale o in un ambiente cloud dedicato. In questo scenario, l'organizzazione gestisce il modello, l'infrastruttura e le modalità di utilizzo. Il vantaggio è un maggiore controllo; il rovescio della medaglia è la necessità di competenze, risorse e capacità operative.
Come il modello accede ai dati
Un secondo asse fondamentale riguarda il rapporto tra modello e dati.
La configurazione più semplice è quella basata solo sul prompt. Tutte le informazioni vengono fornite direttamente nel testo della richiesta. Questa modalità è adatta a compiti generici o creativi, ma diventa rapidamente insufficiente quando servono informazioni specifiche, aggiornate o strutturate.
Un approccio più evoluto è quello basato sul Retrieval Augmented Generation (RAG). In questo caso, il modello non contiene i dati, ma riceve al momento della richiesta solo le informazioni rilevanti recuperate da archivi esterni. I documenti restano separati dal modello e possono essere aggiornati indipendentemente. Il modello svolge il ruolo di interprete e sintetizzatore, non di deposito di conoscenza.
Infine, esiste il fine-tuning, ovvero l'adattamento del modello tramite dati specifici. Questa tecnica modifica il comportamento del modello rendendolo più coerente con uno stile, un dominio o un insieme di compiti ripetitivi. È una soluzione potente, ma meno flessibile e più impegnativa, da utilizzare solo quando le altre opzioni non sono sufficienti.
Le principali combinazioni architetturali
Dall'incrocio tra modello, dati e infrastruttura emergono alcune configurazioni ricorrenti.
Una prima configurazione è quella LLM via API con solo prompt. È la più semplice e immediata, adatta a sperimentazione, uso individuale e supporto generico. Offre rapidità e qualità, ma poco controllo.
Una seconda configurazione molto diffusa è LLM via API con RAG. I dati restano esterni al modello e vengono forniti solo quando servono. Se progettata correttamente, questa architettura consente di lavorare su contenuti proprietari mantenendo un buon equilibrio tra potenza, aggiornamento e controllo.
Una terza configurazione prevede modelli on-premise con RAG. Il modello gira sotto controllo diretto e accede a dati locali. È una soluzione più complessa, ma adatta a contesti regolati o a situazioni in cui i dati non possono uscire dall'infrastruttura dell'organizzazione.
Infine, esistono architetture ibride, in cui modelli locali più piccoli gestiscono i dati sensibili e le richieste ordinarie, mentre modelli più potenti in cloud vengono utilizzati solo per compiti specifici. Un livello di orchestrazione decide di volta in volta quale modello coinvolgere. Questa impostazione consente di combinare controllo, efficienza e potenza, a fronte di una maggiore complessità progettuale.
Un punto chiave
Un elemento spesso frainteso merita di essere chiarito: la privacy e il controllo non dipendono solo dal modello, ma dall'architettura complessiva. Filtraggio dei dati, separazione tra modello e contenuti, orchestrazione delle richieste e governance dell'infrastruttura sono spesso più determinanti della scelta del singolo LLM.
Per questo motivo, parlare di "usare un LLM" ha senso solo se si specifica come lo si sta usando. Le combinazioni possibili non sono un dettaglio tecnico, ma la sostanza della scelta.
La quarta domanda: infrastruttura, costi e sostenibilità nel tempo
Quando un progetto basato su LLM funziona nei primi test, è facile avere l'impressione che la parte più difficile sia alle spalle. In realtà, molte criticità emergono solo quando la soluzione viene usata con continuità, da più utenti o come parte stabile di un processo. È in questa fase che entrano in gioco l'infrastruttura, i costi reali e la sostenibilità operativa.
Un aspetto spesso trascurato riguarda la differenza tra prototipo e utilizzo reale. Un sistema che risponde bene a poche richieste al giorno può diventare lento, costoso o instabile quando il volume cresce. La latenza, la capacità di gestire richieste concorrenti e la disponibilità del servizio diventano fattori centrali, indipendentemente dal tipo di modello scelto.
I costi, inoltre, non si esauriscono nel prezzo del modello o delle chiamate API. Vanno considerati il consumo computazionale, l'eventuale necessità di hardware dedicato, la gestione dei dati, la manutenzione del sistema e il tempo umano richiesto per monitorare e correggere il funzionamento. In molti casi, il costo principale non è tecnologico, ma organizzativo.
Questo vale sia per soluzioni completamente esterne, sia per quelle gestite internamente. Nel primo caso, il rischio è una crescita dei costi difficile da prevedere, legata all'aumento dell'utilizzo o a cambiamenti nelle condizioni del servizio. Nel secondo, il rischio è sottostimare l'impegno necessario per mantenere aggiornato e affidabile il sistema nel tempo.
Un altro elemento cruciale è la scalabilità. Alcune soluzioni funzionano bene finché restano circoscritte, ma diventano difficili da sostenere quando si estendono a nuovi utenti, nuovi casi d'uso o nuovi contesti. Valutare fin dall'inizio se il sistema dovrà rimanere uno strumento locale o diventare una piattaforma più ampia aiuta a evitare ripensamenti costosi.
Infine, parlare di sostenibilità significa anche interrogarsi sulla durata della scelta. Quanto è facile modificare il sistema se cambiano le esigenze? Quanto è semplice sostituire un modello, un fornitore o una componente dell'architettura? Le soluzioni più robuste non sono quelle ottimizzate per il breve periodo, ma quelle che lasciano spazio all'evoluzione.
Chiarire questi aspetti non serve a scoraggiare l'adozione degli LLM, ma a renderla più consapevole. Solo tenendo insieme prestazioni, costi e gestione nel tempo è possibile costruire soluzioni che funzionino davvero, non solo in fase di dimostrazione, ma nella pratica quotidiana.
La quinta domanda: affidabilità, controllo e responsabilità
Quando un sistema basato su LLM entra in un contesto reale di utilizzo, la questione centrale non è più solo cosa è in grado di fare, ma quanto ci si può fidare del suo comportamento. Affidabilità, controllo e responsabilità diventano elementi decisivi, soprattutto quando le risposte del sistema hanno conseguenze concrete.
I modelli di linguaggio non ragionano nel senso umano del termine. Producono risposte plausibili sulla base di probabilità, non di una comprensione verificabile dei fatti. Questo significa che possono generare affermazioni scorrette, incomplete o semplicemente inventate, anche quando il tono è sicuro e convincente. Il problema non è l'errore in sé, ma il modo in cui il sistema gestisce l'errore e il contesto in cui viene utilizzato.
Per questo motivo, una scelta consapevole non può prescindere dal tema del controllo. In molti casi, il valore dell'LLM non sta nel fornire risposte definitive, ma nel supportare il lavoro umano: suggerire, sintetizzare, orientare, lasciando all'utente finale la responsabilità della decisione. Quanto più il sistema si avvicina a compiti operativi o decisionali, tanto più è necessario definire limiti chiari e meccanismi di supervisione.
Un altro aspetto riguarda la tracciabilità. Sapere su quali informazioni si basa una risposta, distinguere ciò che proviene dai dati forniti da ciò che è inferenza del modello, e rendere espliciti i margini di incertezza è fondamentale in molti contesti professionali e istituzionali. Non sempre è possibile ottenere una spiegazione completa, ma è possibile progettare sistemi che rendano visibili le fonti e i passaggi principali.
La responsabilità, infine, non può essere delegata al modello. Che si tratti di un libero professionista, di un'impresa o di una pubblica amministrazione, l'adozione di un LLM implica una scelta consapevole su chi risponde degli output del sistema e su come vengono gestite eventuali conseguenze. Questo vale tanto per l'uso interno quanto per i servizi rivolti all'esterno.
Affrontare questi temi fin dall'inizio aiuta a evitare due errori opposti: da un lato l'entusiasmo ingenuo, che attribuisce al modello capacità che non ha; dall'altro un rifiuto pregiudiziale, che ignora le reali potenzialità di questi strumenti. La chiave sta nel progettare sistemi che tengano conto dei limiti dei modelli, invece di far finta che non esistano.
Conclusione: dal modello al sistema
Arrivati a questo punto, una cosa dovrebbe essere chiara: scegliere una soluzione basata su LLM non significa scegliere un modello, ma progettare un sistema. Il modello di linguaggio è solo uno degli elementi in gioco, spesso nemmeno il più determinante.
Le domande che abbiamo attraversato – cosa deve fare il sistema, quali dati deve usare, come devono essere gestiti, quale tipo di soluzione adottare, come garantirne la sostenibilità e il controllo – valgono in modo trasversale per il singolo professionista, per l'impresa e per la pubblica amministrazione. Cambiano le dimensioni e i vincoli, ma non cambia la logica di fondo.
In molti casi, i risultati migliori non nascono dall'adozione della tecnologia più avanzata, ma da scelte coerenti e proporzionate. Un sistema semplice, ben progettato e governato con attenzione può generare più valore di una soluzione complessa e poco controllabile. Al contrario, l'uso acritico di modelli potenti rischia di creare dipendenza, costi imprevisti e aspettative irrealistiche.
Guardare agli LLM come componenti, e non come soluzioni autosufficienti, aiuta a collocarli correttamente all'interno dei processi. Significa riconoscerne le potenzialità, ma anche i limiti. Significa progettare interazioni, flussi, controlli e responsabilità attorno al modello, invece di affidarsi a esso.
In questa prospettiva, la domanda più importante non è "quale LLM usare?", ma "che tipo di sistema voglio costruire?". È da questa domanda che nasce un'adozione matura e sostenibile dell'intelligenza artificiale, capace di evolvere nel tempo e di adattarsi a contesti diversi senza perdere affidabilità e senso.