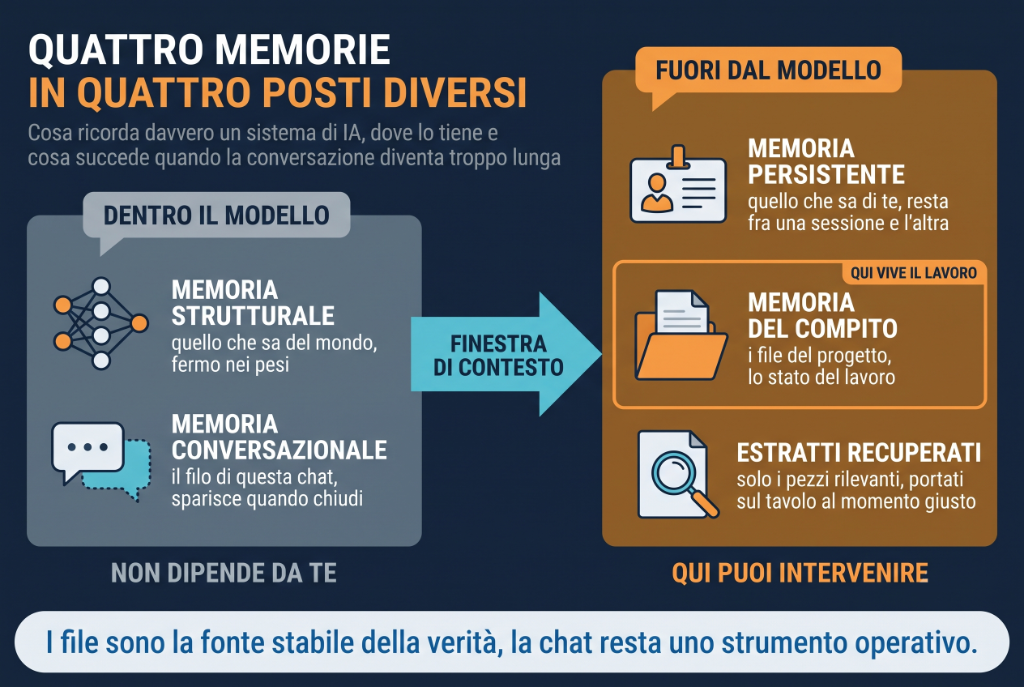
Il concetto di memoria all'interno dell'intelligenza artificiale ha assunto negli ultimi anni un ruolo sempre più centrale. In una fase iniziale, parlare di memoria significava quasi esclusivamente riferirsi alla conoscenza appresa durante l'addestramento. Un sapere distribuito nei pesi della rete neurale, che consente al modello di riconoscere strutture linguistiche, relazioni semantiche e schemi ricorrenti, producendo risposte coerenti. Una "memoria strutturale" del modello. Questa memoria è fondamentale, perché definisce ciò che il modello è in grado di comprendere sul mondo. Allo stesso tempo, però, non riguarda l'utente, i suoi progetti o le sue preferenze. È una memoria stabile, che rimane invariata finché non interviene un nuovo ciclo di addestramento.
A questa memoria strutturale si aggiunge una seconda forma di memoria, legata al dialogo. È la "memoria conversazionale", quella che permette al modello di mantenere il filo di una discussione, riprendere un concetto espresso poco prima, adattarsi alle osservazioni dell'utente o correggersi nel corso della stessa sessione. Questa dimensione coincide con ciò che il modello riesce a "vedere" nella finestra di contesto. È essenziale per la continuità immediata dell'interazione, ma è per sua natura effimera. Quando la conversazione termina o diventa troppo lunga, le informazioni più vecchie escono dal contesto e cessano di influenzare le risposte. Non si costruisce alcuna continuità nel tempo, né una vera identità dell'interazione.
La crescente complessità dei compiti ha reso evidente la necessità di un terzo livello di memoria: la "memoria persistente". Questa memoria non riguarda ciò che il modello sa del mondo, ma ciò che il sistema conserva o ricava sull'utente che lo utilizza. Può contenere preferenze operative, convenzioni stilistiche, indicazioni sul modo di lavorare e informazioni sui progetti. Non coincide necessariamente con un archivio integrale delle chat: può essere composta da ricordi salvati, voci categorizzate o sintesi aggiornate. Contenuti, controlli e tempi di conservazione dipendono però dalla piattaforma, quindi vanno gestiti con la stessa attenzione riservata agli altri dati personali.
A queste forme di memoria interne si è ora aggiunto un elemento esterno che sta diventando sempre più centrale nel lavoro digitale: il "progetto". Il progetto è un ambiente di lavoro che raccoglie file, documenti, bozze, dataset e materiali riferiti a una stessa iniziativa. Non è una memoria dell'intelligenza artificiale, ma una repository strutturata che il sistema può esplorare e interrogare quando serve. I contenuti non vengono incorporati nel modello, ma restano risorse attive che l'IA consulta ogni volta che deve rispondere o prendere una decisione. Il progetto rappresenta una memoria del compito, distinta sia dalla memoria dell'utente sia da quella strutturale del modello, e rende possibile lavorare su testi lunghi, versioni successive e materiali complessi senza perdere il contesto operativo. È utile chiamarla memoria del compito, anche se tecnicamente si tratta di una memoria esterna: non vive nei pesi del modello, ma in un ambiente di lavoro consultabile.
L'uso combinato di queste quattro dimensioni, memoria strutturale del modello, memoria conversazionale, memoria persistente dell'utente e progetto come repository, costituisce oggi l'architettura tipica dei sistemi di intelligenza artificiale più evoluti.
La figura seguente sintetizza dove "vive" ciascuna forma di memoria e come viene richiamata durante l'interazione.
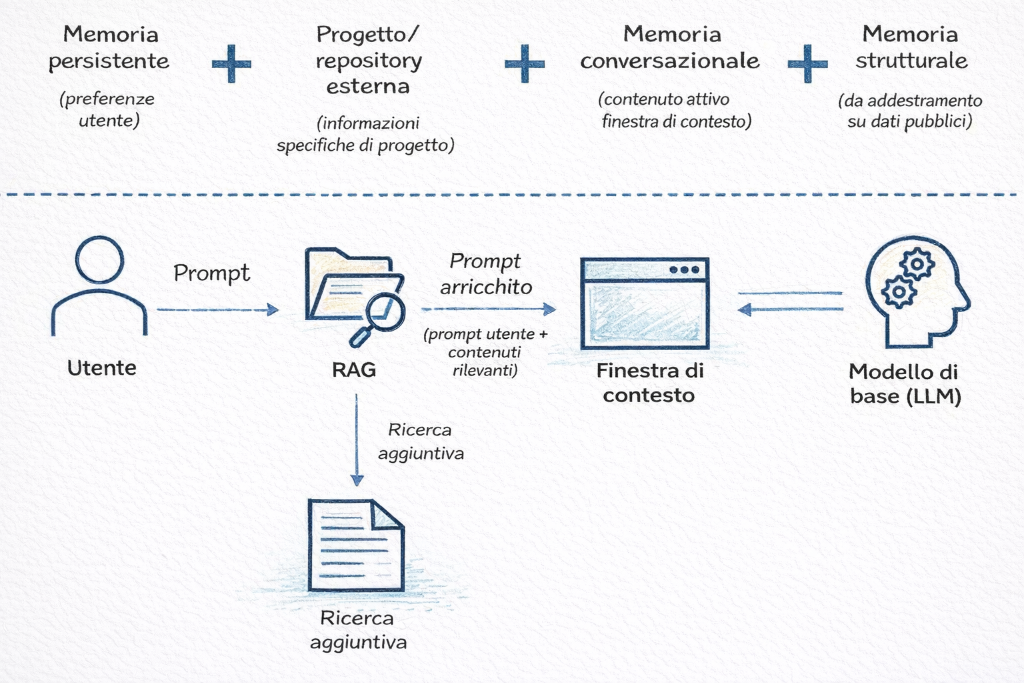
Le diverse piattaforme adottano nomi e soluzioni tecniche differenti, ma la logica sottostante è comune. ChatGPT affianca ricordi salvati, cronologia e una sintesi della memoria che l'utente può ispezionare e correggere. Claude organizza la memoria in voci aggiornate in tempo reale, con spazi separati per i progetti e possibilità di importazione ed esportazione; questa memoria non è attualmente disponibile in Cowork. Gemini costruisce parte del contesto attraverso documenti e servizi dell'ecosistema Google, mentre Copilot può appoggiarsi al Microsoft Graph nell'ambiente aziendale. In tutti i casi emerge la stessa struttura di fondo: conoscenza del modello, contesto temporaneo, memoria persistente, repository e meccanismi di recupero che fanno da ponte tra questi livelli.
L'integrazione tra memorie, repository, strumenti e capacità di azione apre la strada a sistemi in grado non solo di generare testo, ma di collaborare, organizzare e prendere iniziative in ambienti digitali complessi. È una trasformazione che sta cambiando in profondità il modo in cui interagiamo con l'intelligenza artificiale e, sempre più spesso, il modo stesso in cui il lavoro digitale viene organizzato.
Come funziona la memoria conversazionale nei modelli linguistici e che cosa accade quando la conversazione diventa troppo lunga
Il modello non conserva la conversazione come un ricordo umano: a ogni turno lavora sul contesto che la piattaforma gli prepara. La finestra ha una dimensione finita e, nelle conversazioni molto lunghe, le parti iniziali possono essere escluse, sintetizzate o recuperate selettivamente. Anche quando un'informazione è ancora presente, può ricevere meno attenzione in mezzo a molto materiale. Se regole o decisioni importanti non vengono consolidate in una sintesi, in istruzioni stabili o nella documentazione di progetto, rischiano quindi di indebolirsi con il procedere del lavoro.
A questa dinamica si aggiunge un secondo effetto. Le conversazioni lunghe contengono spesso tentativi, versioni intermedie, riscritture e correzioni. Il modello non distingue queste fasi come tappe di un processo, ma le legge tutte come testo potenzialmente valido. In assenza di una sintesi esplicita che chiarisca quale versione è definitiva, il sistema può attingere a istruzioni superate, generando incoerenze o deviazioni di stile.
Un terzo aspetto riguarda il rapporto tra informazione utile e rumore. Più il contesto si amplia, più l'attenzione del modello si distribuisce su elementi secondari. Le istruzioni decisive rischiano di essere indebolite dalla presenza di materiale che non è più rilevante, ma che resta comunque visibile. Quando il rumore supera una certa soglia, la qualità delle risposte può degradare. In presenza di istruzioni in conflitto, il modello non ha modo di distinguere automaticamente quale sia quella definitiva se non viene esplicitata nel contesto.
Per questo i sistemi moderni affiancano alla memoria conversazionale sia la memoria persistente sia i progetti. Le preferenze salvate nella memoria persistente non dipendono dalla lunghezza del dialogo e continuano a essere applicate anche in nuove sessioni. I file presenti nel progetto svolgono invece la funzione di memoria stabile del contenuto. Non diventano ricordi del modello, ma risorse consultabili che permettono di recuperare lo stato del lavoro senza affidarsi alla cronologia della chat.
Quando una conversazione diventa troppo lunga, è utile fermarsi e chiedere una sintesi ordinata delle decisioni finali e delle regole operative. Questa sintesi può essere trasferita in una nuova chat, creando un contesto pulito e privo dei residui delle fasi preliminari. Dichiarare esplicitamente quale versione è definitiva riduce l'ambiguità e migliora la coerenza. Nei progetti complessi è spesso preferibile ancorarsi ai file piuttosto che al flusso della conversazione. I file rappresentano la fonte stabile della verità, mentre la chat resta uno strumento operativo.
Chiedere periodicamente al modello un riepilogo coerente delle scelte compiute è un modo semplice ed efficace per mantenere ordine. Questa operazione filtra il rumore, riporta l'attenzione sulle decisioni chiave e permette di correggere eventuali deviazioni prima che si consolidino. È così che si gestiscono in modo consapevole i limiti della finestra di contesto, sfruttando al meglio la memoria persistente e i progetti quando si lavora su testi lunghi o percorsi che maturano nel tempo.
Cosa cambia con la Agentic AI
Con l'emergere dell'Agentic AI, questo assetto viene riorganizzato attorno all'azione. L'agente non è più un modello che risponde a una richiesta, ma un sistema che pianifica, esegue operazioni, valuta i risultati e adatta il proprio comportamento in funzione di un obiettivo. Un chatbot produce risposte; un agente produce cambiamenti verificabili nello spazio di lavoro. In questo scenario il progetto assume un ruolo operativo centrale. Non diventa una memoria interna dell'agente, ma uno spazio di lavoro esterno che riflette lo stato delle attività in corso.
Il progetto non serve solo a conservare materiali o contesti, ma a rendere visibile e verificabile ciò che è già stato fatto, ciò che è in corso e ciò che resta da fare. In questo modo l'agente può evitare duplicazioni, riconoscere errori già compiuti, aggiornare il progresso del lavoro e coordinare strumenti esterni senza affidarsi al ricordo della conversazione. Il "progetto" cambia quindi natura. Non è più una semplice raccolta di documenti, ma l'ambiente in cui l'azione si svolge e il luogo dove restano tracciate le operazioni eseguite. La memoria conversazionale, persistente e strutturale continua a esistere, ma il progetto diventa il punto di riferimento principale per organizzare il lavoro. In pratica, il progetto diventa la "memoria operativa" dell'agente, distinta sia dal ricordo conversazionale sia dalle preferenze dell'utente.
Nel passaggio dagli assistenti conversazionali agli agenti, l'attenzione si sposta quindi dalla risposta corretta all'azione corretta. Non si tratta solo di generare un testo, ma di modificare file, attivare strumenti, verificare risultati e pianificare ulteriori passi. Il progetto, in questo nuovo contesto, diventa il luogo dove l'agente traccia ciò che ha già fatto e dove conserva i risultati intermedi. È attraverso il progetto che l'agente rende il proprio lavoro ispezionabile e controllabile da parte dell'utente, permettendo una collaborazione trasparente e un intervento correttivo in qualsiasi momento.
Questo cambiamento segna un passaggio importante. L'intelligenza artificiale non genera più solo contenuti, ma agisce in uno spazio di lavoro definito. La memoria non serve più solo a mantenere la coerenza conversazionale, ma a coordinare operazioni complesse, evitare errori e garantire che ogni azione contribuisca all'obiettivo finale. È un'architettura che sta ridefinendo il modo in cui progettiamo i sistemi di intelligenza artificiale e il modo in cui collaboriamo con loro.
Cosa non è la memoria
Quando si parla di memoria nei sistemi di intelligenza artificiale, è importante chiarire anche cosa non è. La memoria che il sistema conserva non equivale alla coscienza di un ricordo, come avviene nell'esperienza umana. Non c'è consapevolezza né un senso del tempo che scorre. Il modello non sa di ricordare qualcosa, ma semplicemente applica il proprio stato interno (la memoria strutturale), rilegge ciò che rientra nella finestra di contesto (memoria conversazionale), consulta preferenze esplicite salvate dall'utente (memoria persistente) o accede a documenti nel progetto quando necessario.
La memoria non è inoltre uno strato che cresce progressivamente, accumulando tutto ciò che avviene. Non è un archivio che registra ogni interazione nel tempo per costruire una storia personale. Il modello non costruisce una biografia della relazione con l'utente, né conserva un diario permanente delle conversazioni passate. Memorizza solo ciò che viene esplicitamente salvato, e solo nei limiti della struttura tecnica che gli viene offerta. La memoria persistente non cresce automaticamente: viene popolata tramite scelte consapevoli, e la memoria conversazionale esiste solo all'interno della finestra di contesto attiva. Quando una conversazione si chiude, ciò che non è stato esplicitamente salvato cessa di esistere per il sistema.
Un altro aspetto importante riguarda la distinzione tra memoria e addestramento. Salvare una preferenza nella memoria persistente non modifica il modello. L'intelligenza artificiale non impara nuovi concetti né aggiorna le proprie capacità attraverso le interazioni con l'utente. Le preferenze non modificano i pesi della rete neurale, ma creano uno strato di configurazione sopra il modello. È una differenza tecnica rilevante. L'addestramento conferisce conoscenze generali e capacità linguistiche, mentre la memoria offre orientamento operativo. L'uno non sostituisce l'altro, e la memoria non compensa una conoscenza che il modello non possiede.
Infine, la memoria non è sinonimo di comprensione profonda. Ricordare una preferenza o riprendere un'informazione dalla conversazione non significa che il sistema abbia colto pienamente il significato di un'esperienza condivisa o abbia sviluppato un'intuizione più sofisticata su come preferisci lavorare. La memoria permette coerenza e personalizzazione, ma resta un meccanismo di recupero e applicazione di regole esplicite o di contesto attivo. Non va confusa con una crescita progressiva della comprensione.