Quando parliamo di machine learning, il pensiero corre subito alle reti neurali e ai moderni modelli di intelligenza artificiale generativa, capaci di scrivere testi, tradurre lingue o riconoscere immagini con una precisione sorprendente (come nel caso di ChatGPT).
Per favorire la comprensione di come si sia arrivati a queste soluzioni, è però utile illustrare le tecniche di machine learning che possiamo definire "tradizionali". Queste tecniche rappresentano il ponte tra i primi tentativi dell'intelligenza artificiale e l'esplosione recente dell'IA generativa.
Dai sistemi esperti al machine learning
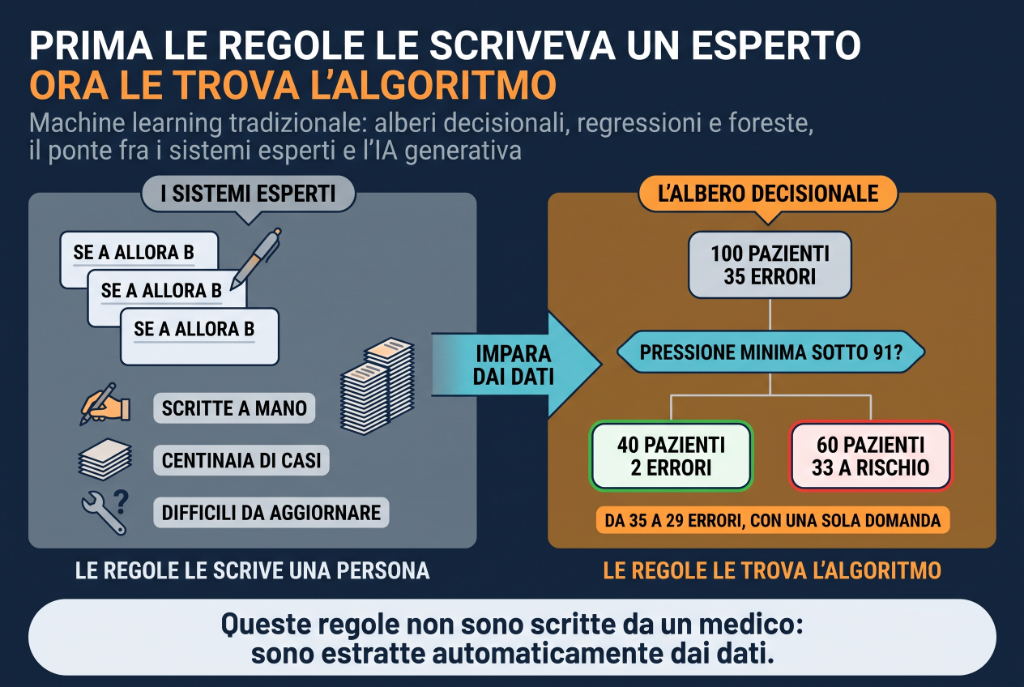
Abbiamo visto i sistemi esperti degli anni Ottanta e Novanta. Funzionavano in modo molto semplice: un gruppo di programmatori e specialisti codificava a mano decine, centinaia o persino migliaia di regole del tipo "se succede A, allora fai B".
Un approccio basato su regole fisse funziona bene in situazioni semplici e ben definite. Tuttavia, quando la realtà diventa più complessa, lo schema si complica rapidamente. Per descrivere tutti i possibili casi clinici bisognerebbe aggiungere decine o centinaia di nuove condizioni, con il rischio di creare un albero decisionale enorme, difficile da leggere, aggiornare e mantenere coerente.
Con l'arrivo del machine learning il paradigma cambia. Non è più necessario che un gruppo di esperti scriva tutte le regole in anticipo: basta fornire al computer una grande quantità di dati storici. L'algoritmo analizza i dati e costruisce da solo le regole più efficaci per distinguere i casi. In questo modo, il sistema "impara dall'esperienza" senza che sia necessario programmare ogni singolo passaggio.
Gli alberi decisionali
Immagina di essere un giovane medico al pronto soccorso. È un sabato sera e arrivano diversi pazienti lamentando un dolore al petto. Il tuo compito è attribuire a ciascuno un colore di priorità: verde se non c'è rischio immediato, rosso se c'è un rischio alto di infarto e serve intervenire subito.
Per decidere, hai a disposizione uno storico di dati su 100 pazienti arrivati in passato con gli stessi sintomi, con informazioni come:
- Pressione minima nelle prime 24 ore
- Età del paziente
- Presenza o meno di tachicardia
- Esito osservato (rischio alto / rischio non alto)
Un algoritmo di machine learning costruisce da solo l'albero decisionale più adatto per separare i due grupi. La differenza è cruciale: queste regole non sono scritte da un medico, ma estratte automaticamente dai dati.
Ottimizzazione delle decisioni
Dai dati osservi che dei tuoi 100 pazienti passati:
- 65 pazienti non erano a rischio
- 35 pazienti invece lo erano
Se non avessi il tempo di fare domande, potresti decidere di assegnare a tutti il colore verde. In questo modo indovineresti 65 volte su 100, ma sbaglieresti 35 volte: il tuo "errore iniziale" sarebbe del 35%.
Ora però decidi di migliorare la tua previsione ponendo una prima domanda chiave: "La pressione minima nelle prime 24 ore è inferiore a 91?"
- Nel gruppo con pressione bassa (40 persone), quasi tutti erano non a rischio: 38 casi corretti e solo 2 errori
- Nel gruppo con pressione alta (60 persone), la maggioranza era a rischio: 33 su 60
Risultato: gli errori totali si riducono da 35 a 29 → la tua decisione diventa più precisa.
Ma non ti fermi: per i pazienti con pressione alta, puoi raffinare la scelta facendo altre domande come l'età o la presenza di tachicardia.
Le altre tecniche di ML tradizionale
Gli alberi decisionali sono solo una delle tante tecniche che appartengono al mondo del machine learning tradizionale.
Regressione lineare e logistica
Sono i metodi più semplici e tra i più antichi. La regressione lineare serve per prevedere valori numerici (ad esempio, stimare la pressione sanguigna media in base all'età e al peso). La regressione logistica, invece, serve per classificare casi in due categorie (ad esempio: rischio sì/no).
Support Vector Machines (SVM)
Quando i dati sono più complessi e non basta una linea retta, le SVM costruiscono confini più sofisticati per separare le categorie. Sono molto utili in problemi come il riconoscimento di immagini o la classificazione di testi.
K-Nearest Neighbours (K-NN)
Questo metodo non costruisce regole generali, ma si basa sulla somiglianza. Per classificare un nuovo caso, guarda i "vicini" più simili nei dati storici: se la maggior parte dei vicini è a rischio, allora anche il nuovo paziente viene classificato come a rischio.
Naïve Bayes
È un metodo che si ispira alla probabilità. Funziona bene quando i dati hanno molte caratteristiche indipendenti tra loro. Ad esempio, viene usato spesso nei filtri antispam: guarda la probabilità che una parola ("gratis", "offerta", "clicca") compaia in una mail di spam o in una mail normale.
Ensemble methods: Random Forest e Gradient Boosting
A volte un singolo albero decisionale può essere troppo fragile o troppo specifico. Una soluzione è costruirne molti e combinarli:
- La Random Forest crea tanti alberi diversi e poi prende la decisione con il voto di maggioranza
- Il Gradient Boosting costruisce alberi uno dopo l'altro: ogni nuovo albero cerca di correggere gli errori del precedente
Questi metodi sono oggi tra i più usati nei problemi di classificazione e previsione su dati tabellari.
Conclusione
Questi metodi, insieme agli alberi decisionali, costituiscono la cassetta degli attrezzi tradizionale del machine learning e sono ancora oggi ampiamente utilizzati, soprattutto quando si lavora con dati strutturati e tabellari (righe e colonne).