Capire

Il modello è il motore, ma tu guidi l'automobile

Perché la differenza tra gli assistenti IA non sta quasi più nel modello - sta in quello che gli viene costruito intorno

Pubblicato il 31 luglio 20268 minuti di lettura
Il modello è il motore, ma tu guidi l'automobile
modelliagenticontestomemoriastrumentiMCPAI Index
Questo tema nel libroParte I - Capire4 capitoli: apri la sintesi e leggi come iniziano

Questa parte ricostruisce da dove viene l’IA, come impara una macchina, come nascono i modelli di linguaggio e che cosa sta intorno al modello: fine-tuning, RAG, finestra di contesto, harness.

I capitoli di questa parte

  • Capitolo 1 · pagina 25Da dove viene l’IA che usi ogni giornoLa nascita dell’IA · Dove siamo oggi

    La chat che usi tutti i giorni nasce da una storia lunga settant’anni. Siamo nel 1950, l’epoca in cui i primi calcolatori entrano nei laboratori. Alan Turing, matematico inglese, si domandò se quelle macchine fossero in grado di pensare. Cercando la risposta si rese conto che il concetto stesso di “pensare” era difficile, se non impossibile, da definire. Cambiò allora prospettiva e concluse che il modo migliore per stabilire se una macchina pensa fosse una prova: se una persona, conversando con un calcolatore, non riesce a capire che sta parlando con una macchina, allora quella macchina ha superato il test. Sei anni dopo, a Dartmouth, John McCarthy diede un nome a quella che stava diventando una disciplina: “intelligenza artificiale, la scienza e l’ingegneria di creare macchine intelligenti”. Molti studiosi si dedicarono a quell’obiettivo, e in poco tempo si consolidarono due approcci diversi. Il primo diceva: scriviamo noi le regole, una per una, e la macchina le applica, come fa un programma tradizionale. Il secondo diceva: diamo alla macchina molti esempi e lasciamo che le regole se le ricavi da sola, con algoritmi ispirati ai neuroni del cervello. La prima strada diede presto risultati tangibili e sembrò la migliore, e lo rimase fino alla fine degli anni Ottanta. Poi, con il crescere della potenza di calcolo, con l’arrivo dei cosiddetti big data e grazie ad algoritmi sempre più raffinati, la seconda strada, quella delle reti neurali artificiali, ebbe la meglio. Nel 2012 una rete neurale profonda (deep neural network) vinse una gara di riconoscimento di immagini con un distacco che nessuno si aspettava. Negli anni seguenti arrivarono i modelli di linguaggio (i large language model), e il 30 novembre 2022 ChatGPT li mise a disposizione del grande pubblico, con una velocità di diffusione da record: oltre cento milioni di persone nei primi due mesi. Il capitolo racconta questa storia e si chiude con una panoramica di quello che l’IA sa fare oggi, dalle proteine alle auto senza conducente. Una cosa da tenere a mente per tutto il libro è la differenza fra le due strade: un programma tradizionale segue istruzioni scritte da qualcuno e dà sempre la stessa risposta; una rete neurale impara dai dati e risponde con la cosa probabilmente più giusta.

    Perché leggerlo: senza questa storia ogni annuncio sembra il primo, e non hai modo di pesarlo. È breve e si legge per intero in mezz’ora; per seguire il resto basta portarsi dietro la distinzione fra regole scritte a mano e regole ricavate dagli esempi, che torna in ogni capitolo.

  • Capitolo 2 · pagina 31Come impara una macchinaIA simbolica: i sistemi esperti · Machine learning: l’apprendimento dai dati · Machine learning tradizionale: la cassetta degli attrezzi · Deep learning: il salto di qualità · Reti neurali artificiali: architetture di base · Reti neurali artificiali: architetture avanzate

    Questo capitolo apre la macchina e racconta, un pezzo alla volta, come fa a imparare. La storia comincia dai sistemi esperti degli anni Sessanta e Settanta. Un esperto umano scriveva le regole, per esempio “se febbre e tosse, allora possibile influenza”, e un programma le applicava una dopo l’altra. Il metodo funzionava finché le regole erano poche; al primo caso che nessuno aveva previsto si rompeva. Il machine learning (l’apprendimento automatico) rovesciò il metodo: invece di scrivere le regole, si raccolgono molti esempi già risolti e si lascia che il programma trovi da solo le regolarità. Un albero decisionale, per esempio, impara da centinaia di pazienti quale domanda fare per prima per capire se un caso è urgente. Queste tecniche, insieme alle regressioni e alle foreste di alberi, decidono ancora oggi se concedere un prestito o come smistare la posta. Hanno però un limite: lavorano su caratteristiche dei dati che qualcuno ha già scelto per loro. Il deep learning fa il passo in più, perché la rete trova da sola che cosa guardare, ed è proprio quello che serve con le immagini, le frasi e i suoni. Per spiegare come, il capitolo parte dal neurone artificiale, il mattone di base delle reti: una somma pesata dei dati in ingresso, seguita da una piccola curva che si chiama funzione di attivazione. Mettendo insieme qualche neurone si ottiene una rete neurale, e con una rete di questo tipo il capitolo mostra come prevedere se uno studente supererà un esame a partire dai risultati di altri studenti prima di lui. Poi quella rete viene addestrata davvero: si parte con pesi scelti a caso, si misura l’errore e si correggono tutti i pesi insieme, un poco alla volta, per migliaia di giri, finché l’errore è il più piccolo possibile. Questo meccanismo, la discesa del gradiente con la backpropagation, è lo stesso che addestra i modelli da miliardi di parametri. Il capitolo si chiude con le quattro architetture che hanno reso possibile l’IA generativa: la diffusione, che impara a togliere il rumore da un’immagine; l’autoencoder, che comprime e ricostruisce; le GAN, due reti che si sfidano; e il Transformer, che con il meccanismo dell’attenzione legge tutte le parole di una frase insieme e decide quali contano per ciascuna.

    Perché leggerlo: è la parte che rende possibile tutto il resto. Senza sapere che cosa sono i pesi e come si addestrano, non è possibile capire davvero perché le risposte dei modelli possono essere sbagliate. Serve leggerlo tutto? No. Per seguire il libro bastano le sezioni sui sistemi esperti e sul machine learning tradizionale, più la sottosezione sul Transformer, in coda alla seconda sezione sulle reti neurali; il resto delle due sezioni sulle reti neurali, con i conti della rete a tre neuroni, si può saltare al primo giro e riprendere quando vorrai vedere come si arriva a quei numeri. Chi salta deve però almeno portarsi dietro tre parole e il loro significato: pesi, addestramento, attenzione.

  • Capitolo 3 · pagina 69I large language modelCome si addestra un modello di linguaggio · Grande non è sempre meglio: i modelli efficienti · Nuove tecniche per migliorare le capacità degli LLM · Chi fa gli LLM, e come li rilascia · Le architetture, in ordine di tempo

    I modelli di linguaggio, i large language model o LLM, sono l’intelligenza artificiale con cui hai a che fare tutti i giorni, e questo capitolo racconta come nascono e chi li costruisce. Un LLM è una rete neurale addestrata a fare una cosa sola: leggere un pezzo di testo e indovinare la parola che viene dopo. Sembra un compito modesto, ma per farlo bene la rete deve assorbire la grammatica, i fatti e i ragionamenti che stanno dietro le parole, ed è così che impara a rispondere, riassumere e tradurre. Tre grandezze decidono quanto un modello è bravo a prevedere la parola successiva: quanti parametri ha, cioè quanti pesi aggiusta mentre impara; quanto testo ha visto; quanto calcolo è servito per addestrarlo. Nel 2020 ci si accorse che l’errore cala in modo regolare quando le tre grandezze crescono. Sono le cosiddette leggi di scala, e da quella scoperta è partita la corsa a costruire modelli sempre più grandi. Il costo di addestramento, però, sale in fretta, e il capitolo racconta le strade che si stanno percorrendo per contenerlo: modelli più piccoli ma addestrati molto più a lungo, oppure pesi scritti con pochi bit, cioè numeri con meno decimali. Presenta poi due tecniche che negli ultimi anni hanno migliorato i risultati a parità di dimensioni: far scrivere al modello un ragionamento prima della risposta, che è l’idea dei modelli di ragionamento, e organizzarlo dentro come una squadra di specialisti che si attivano solo quando servono, la Mixture of Experts. Il capitolo si chiude con chi costruisce questi modelli e come li rilascia: a pesi chiusi, che restano sui server di chi li ha prodotti, oppure a pesi aperti, scaricabili e modificabili; e con quello che ciascun laboratorio ha scelto di vendere.

    Perché leggerlo: qui impari a capire le caratteristiche di un modello nuovo da solo, e ne esce uno al mese. La prima sezione, l’addestramento e le leggi di scala, aiuta a capire come mai leggiamo sui giornali tutti i giorni della corsa alla costruzione di data center sempre più grandi. La sezione sui laboratori si può attraversare in fretta e riprendere quando ti serve un nome.

  • Capitolo 4 · pagina 83Che cosa sta intorno al modelloAdattare un modello al proprio materiale · La finestra di contesto · Capienza e attenzione · L’harness: l’impianto attorno al modello

    Lo stesso modello, dentro due prodotti diversi, può dare risultati lontanissimi. La differenza la fa quello che gli sta intorno, e questo capitolo lo descrive dall’interno verso l’esterno. Un modello appena addestrato ha una conoscenza generale molto ampia, che viene dal materiale su cui è stato addestrato, ma non sa niente di te e del tuo lavoro. Per portarlo sul tuo materiale ci sono due strade. La prima è riaddestrarlo un poco, il fine-tuning: gli si mostrano esempi curati tratti dai tuoi documenti e il modello cambia il modo in cui si comporta, il tono, il formato, il vocabolario di un mestiere. La seconda è collegarlo ai tuoi documenti, la RAG: il modello resta com’è, ma quando arriva una domanda va a cercare nei tuoi file i pezzi che servono e li legge prima di rispondere. La regola per scegliere è semplice: si addestra per insegnare una forma, si dà un documento per aggiungere un fatto. Tutto quello che il modello legge prima di rispondere sta in uno spazio che si chiama finestra di contesto: le istruzioni, la conversazione fino a quel punto, gli allegati, i risultati delle ricerche. La finestra viene riletta per intero a ogni scambio ed è, in pratica, quanto il modello riesce a tenere a mente mentre lo usi. In tre anni la capienza è cresciuta enormemente: i primi modelli tenevano a mente un documento di poche pagine, quelli di oggi lavorano su testi di centinaia di pagine. Restano però dei limiti nella capacità di tenere l’attenzione su tutto quel materiale, e conviene conoscerli. Il capitolo si chiude con l’impianto completo, l’harness: il contesto, gli strumenti che il modello può usare, la memoria, il ciclo con cui rilegge quello che ha fatto e le istruzioni permanenti. Nessuna di queste cinque cose è il modello, e alcune non si comprano: le costruisci tu. È per questo che due persone con lo stesso abbonamento possono avere esperienze molto diverse.

    Perché leggerlo: è il capitolo che presenta tutte le componenti della IA che usiamo tutti i giorni. Ed è proprio utilizzando al meglio queste componenti che è possibile trarre i migliori risultati dalla IA. I capitoli successivi entrano nel dettaglio: la finestra di contesto torna nel capitolo sull’uso della chat, l’harness in quello sugli agenti, la RAG in quello sulla scelta di una soluzione. Va letto per intero; è breve, e la sezione sulla finestra di contesto è la più utile del libro per chi usa una chat tutti i giorni.

Il libro costruisce le basi in modo progressivo; gli articoli approfondiscono e aggiornano i singoli temi man mano che cambiano.

Perché la differenza tra gli assistenti IA non sta quasi più nel modello - sta in quello che gli viene costruito intorno

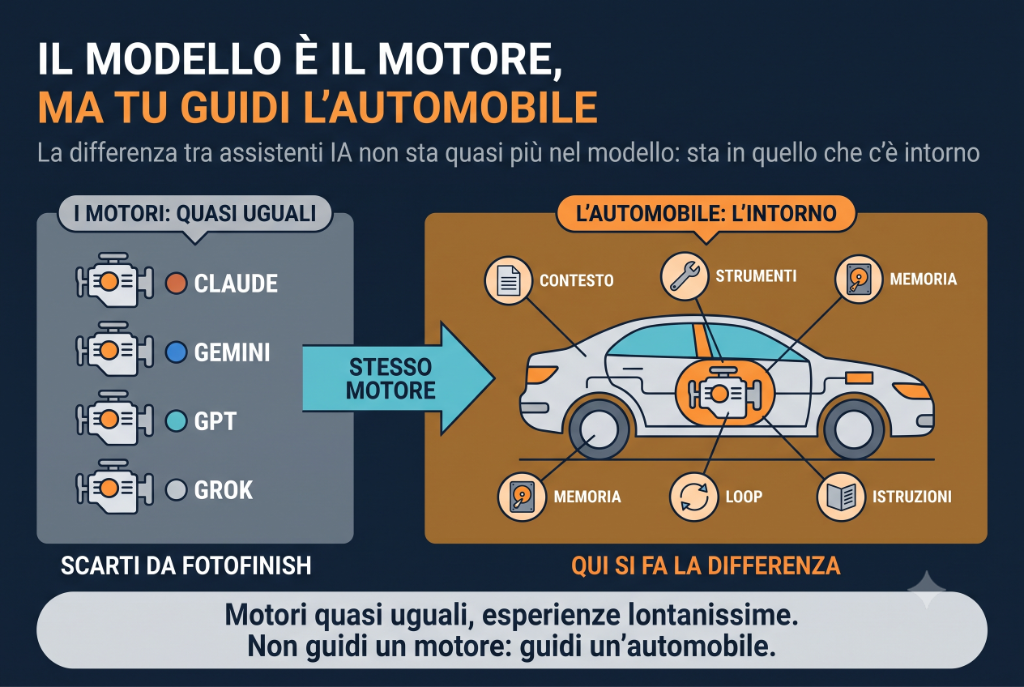
C'è un paradosso che chiunque segua l'IA ha davanti agli occhi, anche senza averlo messo a fuoco. I modelli di punta, nei test, sono ormai quasi indistinguibili: l'AI Index 2026 di Stanford documenta che a marzo 2026 i primi quattro modelli della classifica Arena erano separati da meno di 25 punti Elo - un anno prima il divario tra gli stessi primi quattro era di circa 97 punti. Anthropic a 1.503, xAI a 1.495, Google a 1.494, OpenAI a 1.481: scarti da fotofinish. Il report ne trae la conclusione ovvia: se la capacità del modello non distingue più i concorrenti, la competizione si sposta su costo, affidabilità, utilità nel lavoro reale.

Eppure l'esperienza d'uso, tra un prodotto e l'altro, resta abissalmente diversa. La stessa domanda posta a una chat ti restituisce una risposta generica; posta a un agente di ricerca ti restituisce un'analisi con le fonti; posta a un assistente che ha accesso ai tuoi file ti sistema il documento vero, quello a cui stavi lavorando. Come si conciliano le due cose - modelli quasi uguali, esperienze lontanissime?

Si conciliano con una distinzione che è la tesi di questo articolo: il modello linguistico è il motore, ma tu non guidi un motore. Guidi un'automobile. E due veicoli con lo stesso identico motore possono essere una berlina e un trattore.

Lo stesso motore, veicoli diversi

Il punto non è una metafora a effetto: è letteralmente ciò che accade. Il modello dentro un agente sofisticato è spesso lo stesso identico modello che usi nella chat gratuita - stessa rete, stessi pesi, stesso "cervello". Quello che cambia è l'architettura attorno: cosa il modello vede, cosa può toccare, cosa ricorda, come itera, cosa gli è stato insegnato sul tuo modo di lavorare. Chi costruisce questi sistemi lo dice senza giri di parole: Anthropic, nel suo testo di riferimento su come costruire agenti efficaci, descrive gli agenti come "tipicamente solo LLM che usano strumenti sulla base del feedback dell'ambiente, in un ciclo". Solo. Il valore non è nel componente, è nella costruzione.

Per il lettore di questo sito la conseguenza è concreta: quando confronti due assistenti e uno ti sembra "più intelligente" dell'altro, nella maggior parte dei casi non stai misurando i motori. Stai misurando le automobili.

Anatomia dell'intorno

Di cosa è fatto, questo intorno? Se hai seguito gli articoli dell'ultimo anno, i pezzi li hai già visti tutti - uno alla volta. Messi in fila, formano la carrozzeria completa.

Il primo componente è il contesto: cosa il modello ha davanti nel momento in cui risponde. Non ciò che "sa", ma ciò che vede - i documenti giusti, selezionati e puliti, dentro una finestra che ha limiti veri di capienza e soprattutto di attenzione. Un motore eccellente con il contesto sbagliato produce risposte eleganti e fuori bersaglio; la selezione di ciò che entra nella finestra vale spesso più di un modello superiore. È il principio su cui si regge anche la RAG.

Il secondo sono gli strumenti: le mani. Un modello da solo può soltanto parlare; collegato a ricerca web, file, calendari e sistemi aziendali può agire. Ho raccontato come lo standard MCP stia diventando la presa universale con cui questi collegamenti si fanno - e non è un dettaglio tecnico: decide quanta parte del tuo mondo l'assistente può toccare.

Il terzo è la memoria: cosa il sistema si porta dietro nel tempo. Le preferenze su di te sono il livello di base; il salto vero è la memoria del lavoro - a che punto siamo, cosa è stato deciso e perché - che distingue gli agenti episodici da quelli long-running. Stesso motore, con e senza memoria operativa: due specie diverse.

Il quarto è il loop: il processo con cui il sistema itera invece di rispondere di getto - agisce, osserva il risultato, corregge, riprova. Ne ho scritto in dettaglio nell'articolo sul loop. È il componente che trasforma un sistema che risponde in un sistema che indaga, ed è interamente "intorno": il motore dentro il ciclo è quello di sempre.

Il quinto sono le istruzioni: il mestiere che gli insegni. Le indicazioni permanenti su come lavori, i formati che pretendi, le competenze confezionate che gli metti a disposizione. È la differenza tra un motore generico e uno tarato sulla tua officina.

Nessuno di questi cinque componenti è il modello. Tutti e cinque determinano quello che vivi tu.

La lezione della dinamo

Se questa dinamica ti sembra nuova, la storia economica ha un precedente che le somiglia in modo quasi imbarazzante. L'ha raccontato l'economista Paul David in un articolo del 1990 diventato un classico, "The Dynamo and the Computer".

Quando il motore elettrico arrivò nelle fabbriche a fine Ottocento, la prima cosa che gli industriali fecero fu la più ovvia: sostituire la macchina a vapore con un grande motore elettrico, lasciando tutto il resto com'era - gli alberi di trasmissione, le cinghie, l'edificio a più piani costruito attorno alla vecchia fonte di potenza centrale. Risultato: guadagni di produttività modesti, per decenni. Il salto arrivò solo negli anni Venti, quando le fabbriche vennero ridisegnate attorno alle caratteristiche del nuovo motore - un motore piccolo per ogni macchina, capannoni a un piano, il layout dettato dal flusso dei materiali e non più dalla meccanica delle cinghie. Il valore non stava nel motore: stava nella riorganizzazione che il motore rendeva possibile, e che richiese una generazione per essere concepita.

Sostituisci "motore elettrico" con "modello linguistico" e il parallelo si scrive da solo. Infilare un LLM dentro un flusso di lavoro pensato per gli umani - la chat come sportello a cui fare domande - è l'equivalente del motore elettrico attaccato alle vecchie cinghie: funziona, ma rende una frazione del possibile. L'intorno di cui parlo in questo articolo - contesto, strumenti, memoria, loop, istruzioni - è l'equivalente del ridisegno della fabbrica. Ed è lì che si sta giocando la partita vera.

La parte dell'intorno che costruisci tu

C'è un corollario che mi sta a cuore, perché ribalta un atteggiamento diffuso: quello di chi aspetta che sia il fornitore a fare la differenza. Se il valore sta nell'intorno, allora la domanda "qual è il modello migliore?" - la più frequente che ricevo - è quasi sempre la domanda sbagliata. Quella giusta è: quale ambiente attorno al modello serve al mio lavoro? Che è poi il criterio che avevo proposto parlando di come scegliere una soluzione LLM in pratica.

Ma soprattutto: una parte dell'intorno non la compri - la costruisci tu. I documenti che metti a disposizione dell'assistente sono contesto. Le istruzioni permanenti che scrivi una volta e valgono per sempre sono mestiere insegnato. La memoria che gli lasci accumulare sul tuo lavoro è continuità. Due persone con lo stesso identico abbonamento allo stesso identico prodotto possono avere esperienze lontanissime, perché una ha attrezzato l'ambiente e l'altra no. La competenza da sviluppare, oggi, non è "saper scrivere il prompt perfetto" - è saper allestire l'officina: quali file, quali istruzioni, quale memoria, quali strumenti collegati. Cilindrata che aggiungi tu, non il fornitore.

Il motore conta ancora

E ora il contrappunto, perché la tesi detta senza contrappesi diventerebbe falsa. Il motore conta ancora, eccome. Ogni salto generazionale dei modelli sblocca cose che nessun intorno poteva compensare: gli agenti stessi sono diventati praticabili solo quando i motori hanno superato una certa soglia di affidabilità nel seguire istruzioni, usare strumenti, recuperare dai propri errori. Sotto quella soglia, il loop più elegante del mondo produce solo errori più veloci. E lo stesso AI Index che documenta la convergenza al vertice ricorda che gli agenti falliscono ancora circa un tentativo su tre: il margine di miglioramento del motore è tutt'altro che esaurito.

La formulazione onesta della tesi è quindi questa: a parità di generazione dei modelli, la differenza che vivi tu utente sta quasi tutta nell'intorno. E quando il motore salta di generazione, il primo effetto non è che le chat rispondono meglio - è che diventa possibile costruire un intorno nuovo, che prima non stava in piedi. Motore e carrozzeria si tirano a vicenda: è la carrozzeria a portare il progresso del motore fino a te.

La mappa

Se dovessi condensare l'ultimo anno di articoli di questo sito in una frase, sarebbe questa: ho descritto pezzi di carrozzeria. La finestra di contesto e la sua igiene, la memoria nelle sue forme, gli strumenti e il loro standard, il loop, gli agenti che durano nel tempo. Ognuno di quei pezzi, da solo, è un dettaglio tecnico. Insieme sono la risposta alla domanda con cui questo articolo è partito: perché, con motori ormai quasi uguali, alcuni assistenti ti cambiano il lavoro e altri restano giocattoli. Non è il motore. È l'automobile - e una parte del volante ce l'hai in mano tu.


Articoli correlati su Libro Vivo IA

Glossario
Punteggio Elo (Arena)
Metrica di confronto tra modelli basata su preferenze umane in duelli diretti: differenze piccole indicano modelli quasi equivalenti.
Finestra di contesto
Lo spazio di testo che il modello ha davanti mentre risponde: ha limiti di capienza e di attenzione effettiva.
MCP
Model Context Protocol: standard aperto con cui gli assistenti si collegano a strumenti e fonti dati esterne.
Paradosso della produttività
Ritardo tra l'arrivo di una tecnologia generale e i suoi guadagni misurabili, finché l'organizzazione non viene ridisegnata attorno ad essa.
Resta aggiornato

Un solo aggiornamento per articoli, eventi e nuove edizioni

Nuovi articoli sull'IA
Nuove edizioni del libro ed eventi