E perché nell'analisi, a differenza del codice, l'agente deve costruirsi da solo il proprio giudice
Chiedi a un assistente IA quanto vale un certo mercato in Italia. Un chatbot fa una cosa sola: pesca dalla sua conoscenza, o da una ricerca veloce, e ti dà un numero. Un agente di ricerca fa qualcosa di diverso. Cerca, e trova tre numeri che non coincidono. Invece di sceglierne uno, prende nota della contraddizione - e la contraddizione diventa la sua prossima domanda. Risale alle fonti, scopre che due studi usano definizioni diverse di "mercato", va a cercare il dato originale, ricontrolla, e solo quando il quadro regge si ferma e ti risponde. Con il numero giusto, e con la spiegazione del perché gli altri due erano fuorvianti.
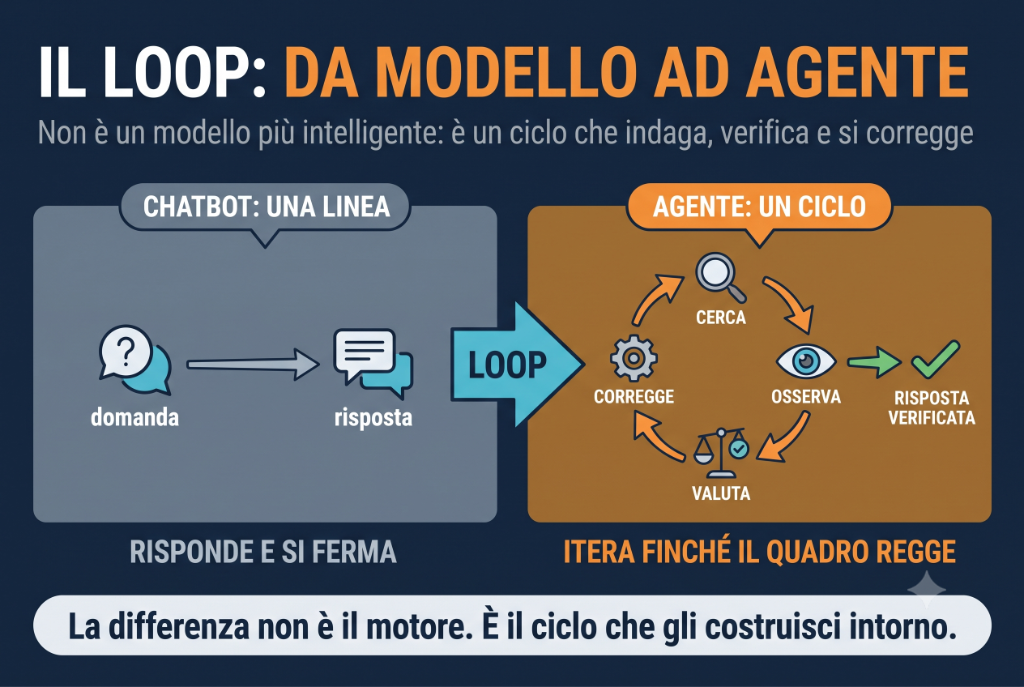
Cosa è successo tra la domanda e la risposta? Non è intervenuto un modello più intelligente. È intervenuto un ciclo: cerca, osserva cosa hai trovato, valuta cosa manca o cosa non torna, cerca ancora. In inglese lo chiamano loop, e la mia tesi è semplice: il loop, non il modello, è ciò che trasforma un sistema che risponde in un sistema che indaga. Se capisci il loop, capisci gli agenti. E capisci anche dove possono tradirti.
Un modello in un ciclo
Della Agentic AI come nuovo paradigma ho già scritto qui: un assistente che non si limita a rispondere ma agisce, usa strumenti, pianifica passi. Qui voglio isolare il meccanismo che sta al centro di tutto, perché è più semplice di quanto il marketing lasci intendere.
Tra chi costruisce questi sistemi la definizione si è ormai assestata, con una convergenza rara in un campo dove le parole cambiano significato ogni sei mesi. Simon Willison, una delle voci tecniche più seguite, l'ha messa in una riga: "un agente LLM esegue strumenti in un ciclo per raggiungere un obiettivo". Anthropic, nel suo articolo di riferimento su come costruire agenti efficaci, usa quasi le stesse parole: gli agenti "sono tipicamente solo LLM che usano strumenti sulla base del feedback dell'ambiente, in un ciclo". Solo. Il modello dentro l'agente è spesso lo stesso identico modello che usi in chat. Cambia l'architettura attorno.
Il ciclo ha quattro elementi, e conviene nominarli perché torneranno tutti. Un obiettivo: cosa va raggiunto. Delle azioni: cercare sul web, leggere un documento, interrogare una banca dati, eseguire un calcolo. Un'osservazione: il risultato dell'azione torna al modello, che lo legge e decide la mossa successiva. E un criterio di arresto: la condizione che chiude il ciclo - obiettivo raggiunto, oppure limite di tentativi, di tempo, di budget. Senza l'ultimo elemento non hai un agente: hai un processo che gira a vuoto.
Un'idea vecchia di ottant'anni
Il loop non l'ha inventato nessun laboratorio di IA negli ultimi anni. È una delle idee più antiche e feconde del pensiero sistemico. Norbert Wiener la mise al centro della cibernetica nel 1948: i sistemi che si autoregolano lo fanno attraverso la retroazione, il feedback - osservano l'effetto delle proprie azioni e correggono la rotta. Il termostato di casa è un loop: misura, confronta con l'obiettivo, agisce, rimisura. Negli anni Settanta il colonnello John Boyd, studiando i duelli aerei, formalizzò il ciclo OODA - osserva, orientati, decidi, agisci - diventato poi un classico della teoria delle decisioni sotto incertezza. E la robotica ha costruito per decenni su varianti dello schema percepisci-pianifica-agisci.
Cosa c'è di nuovo, allora? Una cosa sola, ma grossa. In tutti quei sistemi, il "cervello" dentro il ciclo era rigido: il termostato confronta due numeri, il robot segue regole scritte da un programmatore. Oggi, per la prima volta, dentro il ciclo c'è un componente che capisce il linguaggio - e che quindi può leggere un documento trovato per strada, accorgersi che contraddice un altro documento, e riformulare da solo la domanda successiva. Il feedback non è più un segnale numerico: è testo, con tutta la ricchezza e l'ambiguità del testo. È questo che permette al loop di affrontare problemi aperti, dove i passi necessari non si possono prevedere in anticipo.
Il codice ha un giudice, l'analisi no
Gli agenti hanno funzionato prima di tutto nella programmazione, e non è un caso. Un agente di coding che deve sistemare un errore lancia i test, li vede fallire, modifica il codice, li rilancia, e ripete finché non passano. Il punto non è che il modello sia particolarmente bravo col codice: è che il codice offre al loop un giudice oggettivo. I test passano o non passano. Il compilatore non ha opinioni, non si fa convincere, non si stanca. Ogni giro del ciclo riceve un verdetto esterno, gratuito e affidabile. Anthropic lo dice esplicitamente: il software è il dominio ideale per gli agenti proprio perché "le soluzioni sono verificabili attraverso test automatici".
Ora sposta lo stesso meccanismo sull'analisi - una ricerca di mercato, un'istruttoria, un approfondimento su un tema. Il giudice sparisce. Non esiste un test che "passa" quando la tua stima del mercato è giusta, non c'è un compilatore che rifiuta una conclusione sbagliata. E qui sta il punto concettuale che mi interessa fissare, perché è la vera differenza tra agenti che analizzano e agenti che programmano: nell'analisi, l'agente deve costruirsi da solo il proprio giudice.
Con cosa lo costruisce? Con segnali che deve andarsi a cercare. La contraddizione tra fonti, come nell'esempio in apertura: due numeri che non coincidono sono un test fallito, e il bravo agente li tratta esattamente così. La copertura della domanda: ho risposto a tutti i pezzi, o ho lasciato buchi? La coerenza interna dei numeri: se il segmento A più il segmento B superano il totale dichiarato, qualcosa non va. La qualità delle fonti: sto citando il dato originale o la terza rimasticatura di un comunicato stampa? Anthropic, raccontando come ha costruito il proprio sistema di ricerca multi-agente, descrive proprio questo: agenti istruiti a partire larghi e poi restringere, a valutare la qualità di ogni risultato dopo averlo letto, a identificare i buchi prima di decidere la ricerca successiva. E per valutare i rapporti finali usa una griglia che è, in sostanza, il giudice artificiale di cui parlo: accuratezza dei fatti rispetto alle fonti, corrispondenza tra citazioni e affermazioni, completezza, qualità delle fonti primarie.
La domanda che tiene in piedi tutto il ciclo, nell'analisi, è una: cosa mi smentirebbe? Un agente di analisi ben costruito se la pone a ogni giro. Uno costruito male non se la pone mai - e converge veloce e sicuro verso una risposta ben scritta.
La potenza: ogni giro scava dove il precedente non tornava
Quando il meccanismo funziona, il risultato assomiglia molto al lavoro di un analista esperto. Nessun analista serio scrive il rapporto di getto: fa un primo passaggio largo, vede cosa regge e cosa no, e torna a scavare esattamente dove non tornava. Il loop automatizza questa spirale. Il primo giro produce una mappa grossolana e piena di difetti; i difetti del primo giro diventano il programma di lavoro del secondo; e così via, restringendo. La risposta imperfetta non è uno scarto: è l'input del giro successivo.
C'è anche un guadagno più sottile. Un modello che risponde in un colpo solo non può accorgersi di aver sbagliato, per costruzione: produce la risposta e ha finito. Un modello in loop vede il risultato delle proprie azioni, e quindi ha almeno la possibilità di correggersi. È la stessa differenza che passa tra lo studente che consegna il compito di getto e quello che lo ricontrolla: non è più intelligente, ha solo un processo migliore.
La debolezza: coerente non vuol dire vero
E ora la parte che gli articoli entusiasti saltano, cioè il motivo per cui non affiderei mai un'analisi a un agente senza controllarla.
Primo: senza giudice oggettivo, il loop può convergere su una narrazione coerente ma sbagliata. Il criterio di arresto dell'agente di analisi è, in ultima istanza, "tutto torna". Ma "tutto torna" può accadere per la ragione sbagliata: magari le tre fonti che confermano il dato si stanno copiando a vicenda, e la convergenza che l'agente scambia per solidità è solo l'eco di un'unica fonte originaria - magari sbagliata. La coerenza interna non è verità. Nel codice questo scenario è quasi impossibile, perché i test ancorano il loop alla realtà; nell'analisi non c'è àncora, se non quella che il processo si costruisce.
Secondo: gli errori si accumulano. Prendi un agente che a ogni passo ha il 95% di probabilità di fare la mossa giusta - una percentuale generosa. Dopo venti passi, la probabilità che tutti i passi siano stati corretti scende sotto il 36%: quasi due volte su tre, da qualche parte nella catena c'è almeno un errore. Nel coding il test lo intercetta al giro successivo. Nell'analisi, un errore di definizione commesso al secondo giro - "mercato" inteso in senso largo invece che stretto - inquina silenziosamente tutti i giri che seguono, e nessun allarme suona. Anthropic, parlando dei propri sistemi in produzione, usa una formula che vale la pena ricordare: "gli agenti mantengono uno stato e gli errori si compongono" - un passo storto può portare l'intera traiettoria altrove.
Terzo, e lo dico per esperienza diretta: il punto in cui il cedimento si vede meglio sono le citazioni. Lavorando ai miei testi ho preso l'abitudine di verificare una per una le fonti che gli assistenti mi propongono - autori, titoli, DOI, link. Una parte non trascurabile non regge il controllo: articoli mai esistiti, autori giusti su titoli sbagliati, link che puntano altrove. Un agente in loop, se non ha un passo esplicito di verifica delle fonti, non si limita a inventare una citazione: ci costruisce sopra i giri successivi. L'errore non resta locale, diventa fondamenta.
C'è infine un rischio più sottile, imparentato con la sicofanzia di cui ho già scritto: se la domanda che dai all'agente contiene già la risposta che speri ("conferma che il mercato X è in crescita"), il loop può orientare le ricerche a confermarla. Un ciclo che parte inclinato non si raddrizza da solo: si avvita. La qualità della domanda iniziale, nell'analisi agentica, non è un dettaglio di forma - è il primo parametro del sistema.
Il mestiere si sposta: disegnare il loop
Tiro le fila. Se l'agente è un modello in un ciclo, allora il lavoro di chi usa gli agenti per analisi non è più scrivere il rapporto: è disegnare il ciclo. Quattro scelte concrete.
La domanda, formulata in modo che non contenga già la risposta, e con il perimetro esplicito: cosa intendo per "mercato", quale geografia, quale periodo. Ogni ambiguità lasciata aperta è un errore di definizione che l'agente commetterà al posto tuo, al secondo giro, in silenzio.
Il criterio di arresto: quando il lavoro è "abbastanza"? Quante fonti indipendenti servono per considerare solido un dato? Un limite di giri e di budget c'è comunque - ogni giro riempie la finestra di contesto e costa, un tema che ho trattato parlando della risorsa scarsa dell'IA, l'attenzione - tanto vale deciderlo tu invece di subirlo.
Il passo di verifica, dentro il loop e non dopo: chiedere esplicitamente all'agente di cercare cosa smentisce la conclusione, di controllare che le citazioni esistano, di segnalare quando più fonti derivano dalla stessa origine. È il pezzo di giudice che puoi installare tu.
E il checkpoint umano, che nell'analisi non è un vezzo prudenziale: è il vero test finale. Nel coding guardi se i test passano; nell'analisi verifichi le fonti a campione e sfidi la conclusione - "cosa dovrebbe essere vero perché questo numero sia giusto?". Se non regge alla domanda, il loop deve ripartire.
Gli agenti che analizzano per noi sono già qui e diventeranno rapidamente normali - così come sta emergendo la generazione successiva, quella degli agenti che portano avanti il lavoro nel tempo. Il modo sbagliato di usarli è trattarli come oracoli che restituiscono rapporti finiti. Il modo giusto è trattarli per quello che sono: cicli di indagine molto veloci e molto instancabili, che ereditano la qualità del disegno che gli dai - e che, in mancanza di un giudice esterno, hanno bisogno che il giudice ultimo resti tu.