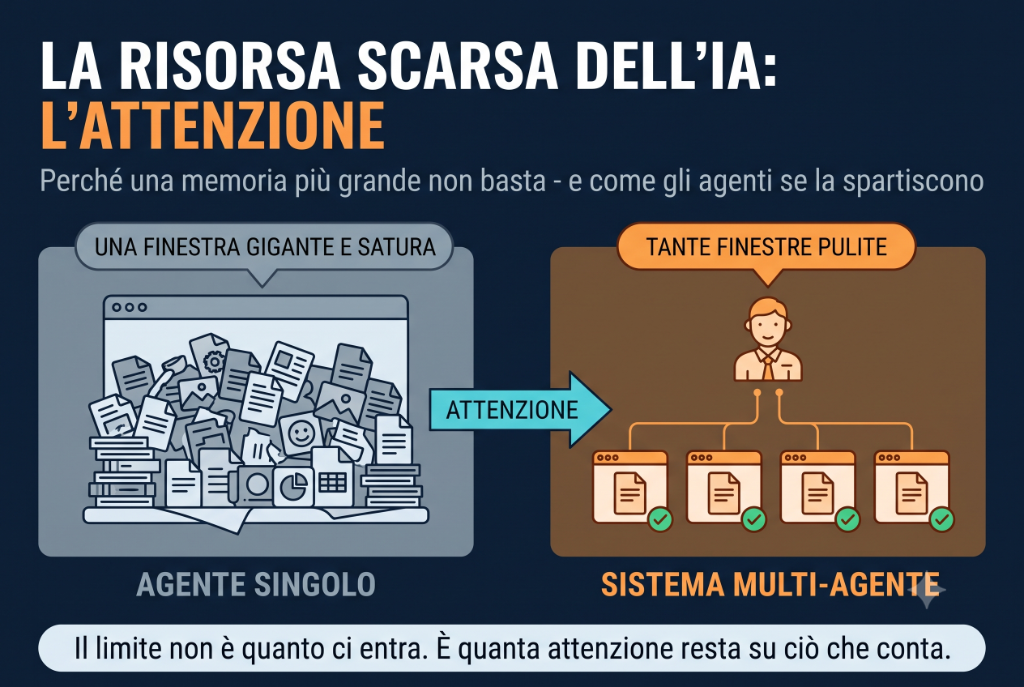
Immaginiamo un assistente IA al lavoro su un compito lungo: deve leggere un report di duecento pagine, incrociarne i numeri con un foglio di calcolo e scriverne la sintesi. Per la prima mezz'ora fila tutto. Poi qualcosa si rompe. Ripete un'analisi che aveva già chiuso. Torna a chiedere un documento che aveva già in mano. Non è diventato più stupido: ha riempito la sua finestra di contesto, e una finestra intasata il modello la usa male.
La finestra di contesto è la memoria di lavoro dell'agente. Tutto quello che ha davanti in quel momento — le istruzioni ricevute, i documenti aperti, ogni mossa già fatta — sta lì dentro, e lì dentro c'è un limite. Si misura in token, le unità in cui il modello spezza il testo, e fino a poco fa quel limite era il vero collo di bottiglia. Oggi molto meno: i modelli di punta arrivano a uno o due milioni di token, e un modello open, Llama 4 Scout, ne dichiara dieci milioni — l'equivalente di migliaia di pagine in un colpo solo. Sembra la fine del problema.
Non lo è. Ed è qui che vale la pena fermarsi, perché la reazione istintiva — "allora prendo un modello da dieci milioni di token e ho risolto" — è esattamente quella sbagliata.
Quanto ci sta non è quanto il modello legge
Bisogna tenere separate due cose che la parola "finestra" fa sembrare una sola: quanto ci sta dentro, e quanto bene il modello usa ciò che c'è dentro. La prima è capienza. La seconda è attenzione. Crescono insieme nei materiali di marketing, ma nella pratica no.
Chi usa gli assistenti IA è sicuramente incappato in questo problema, magari senza riconoscerlo: la chat che a un certo punto comincia a perdere il filo e a dimenticare, segno che la finestra si è saturata — ne ho già parlato qui: come riconoscere una chat satura. E come è fatta dentro questa finestra, in che modo il testo viene spezzato e dato in pasto al modello, l'avevo raccontato parlando di chunking e finestra di contesto. Qui faccio il passo successivo: anche con una finestra enorme, il problema non sparisce.
Il fenomeno ha un nome ormai consolidato tra chi costruisce questi sistemi: "context rot", il contesto che marcisce. Più si allunga l'input, meno il modello resta affidabile — anche su compiti banali come ritrovare un'informazione o ricopiarla. Nel 2025 il gruppo di ricerca di Chroma ha messo alla prova diciotto modelli di frontiera (tra cui GPT-4.1, la famiglia Claude 4, Gemini 2.5, Qwen3) e ha trovato che l'accuratezza cala in modo non uniforme con la lunghezza dell'input, a volte del 30-50%, e ben prima del limite dichiarato. Una finestra da due milioni di token può lavorare in modo affidabile su una frazione di quei due milioni; il resto è capienza che esiste sulla scheda tecnica ma che il modello non sfrutta con la stessa qualità.
C'è un secondo effetto, più vecchio e più studiato, che spiega il meccanismo. Si chiama "lost in the middle", perso nel mezzo. In uno studio del 2023 diventato un classico, Nelson Liu e colleghi di Stanford hanno mostrato che i modelli ritrovano molto bene un'informazione se sta all'inizio o alla fine del testo, e molto male se sta nel mezzo. La curva delle prestazioni ha la forma di una U: si presta attenzione ai bordi e si trascura il centro — e vale anche per i modelli progettati apposta per i contesti lunghi. Allungare la finestra non raddrizza la U. Semmai allunga il centro, cioè la zona dove l'attenzione si dirada.
Tradotto: dare a un lavoratore distratto una scrivania più grande non lo rende più attento. Gli dà solo più roba da ignorare. Il limite vero non è lo spazio sul tavolo, è quante carte quel lavoratore legge davvero prima di decidere. Una finestra dieci volte più capiente, ma riempita per intero di materiale per lo più irrilevante, lavora peggio di una finestra piccola e curata. E intanto costa di più e risponde più lenta, perché il conto in token e il tempo di calcolo salgono con tutto ciò che le infili dentro.
La questione va affrontata al contrario: non è un problema di capienza da risolvere con un contenitore più grande, ma di attenzione da risolvere con la selezione. La domanda giusta non è "quanto ci entra", è "come tengo pulito ciò che conta".
Le mosse del singolo agente
Prima di tirare in ballo più agenti, vale la pena vedere come un agente da solo prova a difendere la propria attenzione, perché il multi-agente è la generalizzazione di queste stesse idee.
La prima mossa è la compattazione: quando la conversazione si allunga, l'agente riassume ciò che ha fatto fino a quel momento e butta via la cronologia grezza, tenendo solo il distillato. La seconda è la memoria esterna: invece di trascinare tutto dentro la finestra, l'agente scrive su un supporto esterno — un piano di lavoro, dei risultati intermedi — e lo rilegge quando serve, liberando spazio prezioso. È un tema che ho trattato sia nella tassonomia delle diverse forme di memoria della IA, sia parlando di come costruire una memoria permanente. La terza mossa è il recupero selettivo: tenere fuori dalla finestra il grosso dei documenti e portarci dentro solo il frammento rilevante al momento giusto — il principio su cui si regge la RAG, che non a caso si fonda sulla selezione e non sull'accumulo.
Tutte e tre rispondono alla stessa logica: meglio poco e pertinente che tutto e indistinto. Sono però rattoppi su un vincolo di fondo — un agente solo, una sola finestra, una sola attenzione da spartire tra ogni cosa che fa. Da qui il salto.
Il salto: dividere il contesto
L'idea che negli ultimi due anni ha portato a riorganizzare il modo di costruire agenti è semplice: invece di un agente che tiene tutto in testa (un'unica finestra di contesto), un sistema di agenti ciascuno con la propria finestra di contesto che si spartiscono il lavoro. Un agente capo, l'orchestratore, tiene lo stato alto del problema e delega i sottocompiti ad agenti subordinati. Ognuno di questi lavora nella propria finestra, pulita e dedicata a un solo pezzo, e restituisce al capo non tutto il suo ragionamento, ma solo il risultato compresso (se non è chiaro cosa sia un agente, ne ho scritto qui: agentic AI e il nuovo paradigma dell'azione).
La metafora utile è quella del capo progetto che non legge ogni email dei collaboratori: riceve i memo. Se dovesse leggere tutto, la sua testa si intaserebbe esattamente come la finestra dell'agente solo del nostro report.
Anthropic ha descritto pubblicamente un sistema costruito così — la funzione di ricerca di Claude — e i suoi numeri valgono più di una metafora. L'architettura è quella "orchestratore-lavoratori": un agente capo che genera agenti subordinati in parallelo, ciascuno con la propria finestra. La loro frase sintetizza il punto meglio di qualsiasi parafrasi: "l'essenza della ricerca è la compressione". I subordinati esplorano in parallelo, distillano, e passano al capo solo i token che contano. Nel loro test interno, il sistema multi-agente ha superato il singolo agente più potente del 90%. E il dato che chiude il cerchio con tutto il discorso sull'attenzione: l'uso di token spiega da solo l'80% della varianza nei risultati. Distribuire il lavoro su più finestre separate non è un vezzo, è il modo di dare al problema più capacità di attenzione utile senza intasare una finestra sola.
Questo ribalta anche l'intuizione sulla parallelizzazione. Quando moltiplichi le finestre non stai solo guadagnando tempo: stai guadagnando budget di attenzione. Dieci finestre pulite valgono, per qualità del risultato, più di una sola finestra gigante e satura. Il parallelismo è una mossa contro il degrado, prima ancora che per la velocità.
Non esiste un solo modo di dividere
Qui sta il punto che distingue chi ha davvero messo le mani in questi sistemi da chi ne parla per sentito dire. "Agenti specializzati" e "agenti in parallelo" non sono due scuole opposte: sono assi indipendenti. Si divide il lavoro tra più agenti per tre motivi diversi, che spesso vengono confusi.
Strumenti e permessi. Un agente ha quel connettore, quelle API, quei diritti di accesso. Pensiamo a un assistente di customer care che gestisce resi: l'agente che parla col cliente non tocca il database. Quando serve un rimborso, chiama un agente subordinato che ha le credenziali sul gestionale e il permesso di emettere rimborsi fino a una soglia. Li separi non per il contesto, ma perché non vuoi che lo stesso modello che improvvisa frasi col cliente abbia in mano l'accesso in scrittura alla produzione. La specializzazione è anche contenimento del danno: se l'agente conversazionale viene manipolato con un'istruzione malevola, non può svuotare la cassa. Il fatto che gli agenti accedano agli strumenti esterni attraverso uno standard comune — MCP, lo standard aperto che si sta imponendo per l'accesso degli agenti agli strumenti — rende questa specializzazione molto più facile da costruire.
Igiene del contesto, ed è il motivo che lega tutto alla nostra tesi. Un agente subordinato apre un PDF di sessanta pagine, fa quindici tentativi con i suoi strumenti, scarta i vicoli ciechi, e torna al capo con cinque righe: "il dato che cercavi è a pagina 34, vale questo, fonte questa". Le sessanta pagine e i quindici tentativi non entrano mai nella finestra principale. Il capo resta lucido perché ha visto i memo, non il lavoro sporco.
Throughput: parallelizzi perché il lavoro è indipendente e vuoi farlo in meno tempo. E qui c'è una distinzione che il lettore tecnico apprezzerà, perché "agenti paralleli" indica due cose opposte. Da un lato il map-reduce: devi confrontare dieci fornitori, mandi dieci agenti, uno per fornitore, e poi un agente fonde le dieci schede. Dall'altro il voting: lo stesso problema difficile — un pezzo di codice ostico — dato a cinque agenti identici in parallelo, e tieni la soluzione che passa i test o quella su cui la maggioranza converge. Stesso compito, finestre separate, ma il primo divide il lavoro e il secondo lo ripete per ridurre l'errore. Lo stesso sistema di ricerca di Anthropic mostra il caso da manuale: alla richiesta di elencare tutti i consiglieri di amministrazione delle aziende tech dell'indice S&P 500, l'agente solo procede in fila e non arriva in fondo; il sistema che spacca il compito tra più agenti ci riesce.
Sopra questi tre motivi corre una leva trasversale: la scelta del modello. Non serve usare lo stesso modello per tutto. Un modello piccolo ed economico basta e avanza per i sottocompiti stretti — estrarre, classificare, riassumere — mentre quello costoso lo tieni per l'orchestratore, che deve ragionare e tenere il filo. Nel sistema di Anthropic il capo è il modello più potente e i subordinati sono modelli più leggeri. È risparmio, ma non solo: il modello piccolo ha spesso anche una finestra più piccola, e va benissimo, perché gli dai un compito già ritagliato. Il cerchio si chiude con l'igiene del contesto — gli dai poco proprio perché deve fare poco. E che si possano costruire modelli sempre più piccoli ed efficienti senza buttare via la qualità è ciò che rende questa scelta economicamente sensata.
Il prezzo della soluzione
Però. C'è un però. Niente di tutto questo è gratis. La frammentazione costa. Anthropic dichiara i suoi numeri senza girarci intorno: un agente consuma circa quattro volte i token di una normale conversazione, e un sistema multi-agente circa quindici volte. Va bene per compiti il cui valore giustifica la spesa, non per qualsiasi cosa.
Poi c'è la latenza: coordinare più agenti aggiunge attese e passaggi. E c'è il difetto più sottile, quello che gli stessi ingegneri chiamano "game of telephone", il telefono senza fili: ogni volta che un agente passa informazioni a un altro, qualcosa si perde nella compressione. Il memo è più pulito del lavoro grezzo, ma è anche più povero — e se la sfumatura persa era quella decisiva, il capo decide su un'immagine sfocata. Una delle contromisure è far scrivere i risultati su un archivio condiviso invece di farli rimbalzare da un agente all'altro, così il dato originale resta recuperabile.
C'è infine un onesto limite di applicabilità. Il multi-agente brilla dove il lavoro si lascia spezzare in pezzi indipendenti — la ricerca è il caso ideale. Rende molto meno dove i pezzi dipendono strettamente l'uno dall'altro: lo stesso Anthropic ammette che per la programmazione il guadagno è minore, perché i sottocompiti sono meno parallelizzabili e gli agenti non sanno ancora coordinarsi bene in tempo reale. E proprio la dimensione temporale — agenti che vivono una singola sessione contro agenti che portano avanti un lavoro per giorni — apre problemi di contesto ulteriori, di cui ho parlato distinguendo agenti episodici e agenti long-running.
Dove porta tutto questo
La finestra di contesto sembra un dettaglio tecnico e invece detta l'architettura. Finché la si è letta come un problema di capienza, la risposta è stata "facciamola più grande", e i numeri sono cresciuti fino ai milioni di token. Ma il vincolo che conta non è quanto entra: è quanta attenzione il modello riesce a tenere su ciò che conta. Letta così, la frammentazione in più agenti smette di essere un trucco di efficienza e diventa quello che è — il modo di trattare l'attenzione come la risorsa scarsa, dandone un po' a ciascuno.