La maggior parte dei Large Language Model (LLM) oggi in uso genera testo seguendo un paradigma autoregressivo. In pratica, il modello produce un token alla volta, basandosi su quelli già generati. È lo stesso principio che governa molti modelli di linguaggio sin dagli inizi del deep learning: prevedere il prossimo elemento di una sequenza, aggiungerlo al contesto e ripetere il processo fino al completamento del testo.
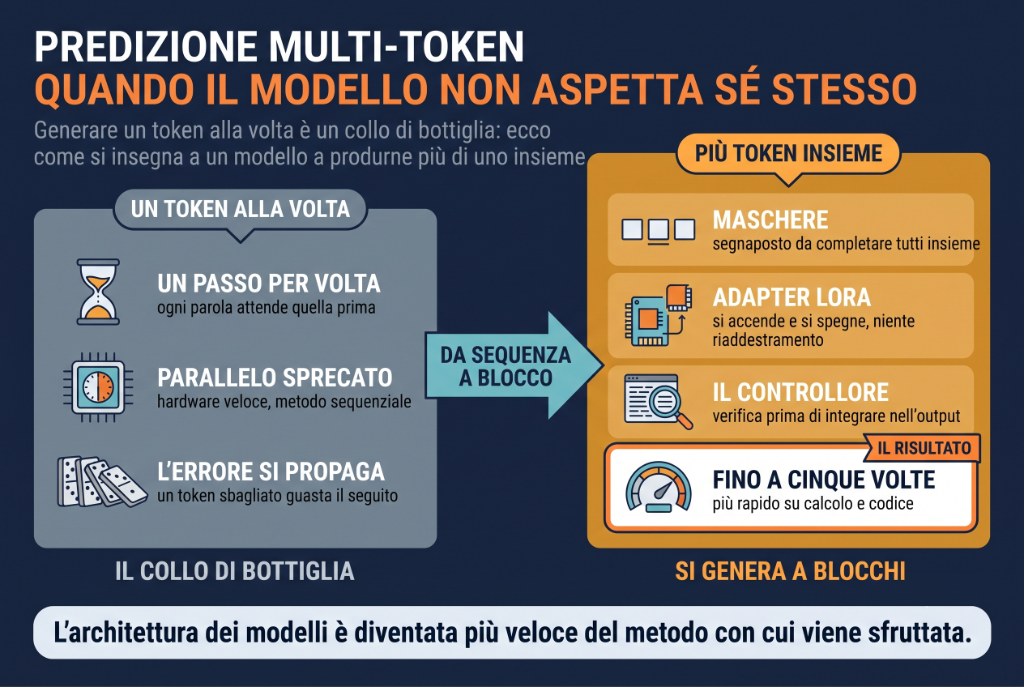
Questo approccio ha dimostrato una straordinaria efficacia. Ha permesso di costruire modelli sempre più grandi, coerenti e capaci di gestire contesti complessi. Allo stesso tempo, però, porta con sé un limite strutturale: la generazione procede in modo rigidamente sequenziale. Anche su hardware altamente parallelo, come le GPU moderne, il modello è costretto ad "aspettare sé stesso" a ogni passo. È un collo di bottiglia che incide su velocità, costi e consumi energetici.
Negli ultimi anni, mentre l'hardware ha continuato a migliorare rapidamente, questo vincolo algoritmico è diventato sempre più evidente. È in questo contesto che si inserisce il lavoro di un gruppo di ricercatori di Apple, che ha esplorato un approccio alternativo alla generazione del linguaggio: la predizione multi-token.
Cos'è un token e perché conta
Per comprendere il cambiamento, è utile chiarire cosa sia un token. Un token è l'unità minima di testo elaborata da un modello di linguaggio. Può corrispondere a una parola intera, a una parte di parola o a un simbolo di punteggiatura. Le frasi vengono scomposte in sequenze di token, che il modello trasforma in rappresentazioni numeriche per calcolare le probabilità delle unità successive.
Nel paradigma autoregressivo, ogni token viene generato uno dopo l'altro. Il modello calcola la distribuzione di probabilità del token successivo, ne seleziona uno, lo aggiunge alla sequenza e ricomincia da capo. Questo garantisce coerenza locale e stabilità del processo, ma rende la generazione intrinsecamente lenta.
Il limite del paradigma autoregressivo
Il successo dell'approccio autoregressivo non è casuale. Predire il prossimo token è un problema ben definito, facilmente ottimizzabile e compatibile con l'architettura Transformer. È anche uno schema di addestramento stabile, che ha consentito la crescita dimensionale degli LLM.
Tuttavia, proprio questa semplicità introduce una dipendenza sequenziale rigida. Ogni passo richiede un'elaborazione completa del contesto corrente, anche quando il contenuto da generare è altamente prevedibile. In altre parole, l'architettura dei modelli è diventata più veloce del metodo con cui viene sfruttata.
L'idea alla base della predizione multi-token
La predizione multi-token nasce per superare questo limite. Invece di generare un solo token per iterazione, il modello viene addestrato a prevederne più di uno simultaneamente. Riducendo il numero di passaggi necessari, il flusso di generazione accelera in modo significativo.
Una metafora utile è quella del linguaggio umano. Quando parliamo, raramente costruiamo le frasi parola per parola senza una visione d'insieme. Spesso abbiamo già in mente una struttura, o almeno un frammento coerente, prima di articolare i singoli termini. Il multi-token cerca di avvicinare il comportamento del modello a questa logica: non eliminare la probabilità, ma estenderla su più posizioni future.
Dal punto di vista concettuale, il modello non prevede una sequenza rigida, ma una distribuzione congiunta di token futuri. È un piccolo spostamento cognitivo, che introduce una forma embrionale di pianificazione nella generazione del testo.
Come implementare il multi-token: due strade possibili
Un modo per ottenere questa capacità sarebbe addestrare un LLM da zero, progettando architetture e funzioni di perdita specifiche per la predizione multi-token. È una strada teoricamente valida, ma estremamente costosa in termini di dati, tempo e risorse computazionali.
I ricercatori di Apple propongono invece un approccio incrementale e pragmatico: partire da modelli già addestrati e abilitarli alla generazione multi-token attraverso meccanismi aggiuntivi. Questo rende la soluzione più sostenibile e facilmente integrabile nei sistemi esistenti.
Le maschere di predizione
Il primo elemento chiave sono le maschere di predizione. Durante l'addestramento, vengono inseriti token segnaposto, come [mask], alla fine della sequenza. Il modello viene istruito a completare simultaneamente più posizioni future.
Questo schema ricorda, in parte, il funzionamento dei modelli bidirezionali come BERT, ma con una differenza cruciale: qui l'obiettivo resta la generazione del testo. Il modello impara a "riempire buchi" futuri mantenendo coerenza semantica e sintattica su più token, anziché concentrarsi solo sul passo immediatamente successivo.
Il risultato è un addestramento che rafforza la capacità del modello di ragionare su blocchi di testo, non solo su transizioni locali.
Gli adapter LoRA come leva strategica
Il secondo elemento fondamentale sono gli adapter LoRA (Low-Rank Adaptation). Si tratta di moduli leggeri che si innestano su una rete neurale già addestrata, modificandone il comportamento senza alterarne i pesi principali.
Nel caso della predizione multi-token, LoRA consente di introdurre questa nuova modalità di generazione senza riaddestrare l'intero modello. Quando l'adapter è attivo, orienta la rete verso la produzione simultanea di più token; quando è disattivato, il modello torna al comportamento autoregressivo standard.
Questo aspetto è particolarmente rilevante. Il multi-token non diventa una caratteristica irreversibile del modello, ma una capacità attivabile. È un esempio concreto di AI modulare, in cui il "sapere" del modello resta stabile, mentre il suo comportamento operativo può essere adattato al contesto d'uso.
Il ruolo del controllore: verificare prima di integrare
Per preservare la qualità dell'output, il sistema introduce un controllore. Questo componente verifica la coerenza dei token previsti in anticipo rispetto al contesto. Se individua incongruenze o errori, può scartare o sostituire i token problematici prima che vengano integrati nella sequenza finale.
Il controllore svolge una funzione cruciale: separa la fase di proposta da quella di validazione. In questo modo riduce la propagazione degli errori, uno dei limiti più noti della generazione autoregressiva, in cui un token sbagliato può compromettere l'intera continuazione del testo.
Questa architettura anticipa un'evoluzione più ampia: modelli non più monolitici, ma composti da più componenti che collaborano, controllano e correggono il processo generativo.
I risultati sperimentali
Secondo i dati riportati dai ricercatori, l'approccio multi-token offre miglioramenti significativi in termini di velocità:
- fino a cinque volte più rapido in compiti di calcolo e generazione di codice
- fino a due volte e mezzo più veloce nelle conversazioni
Il tutto senza una perdita qualitativa rilevante. In molti casi, l'output risulta addirittura più fluido, perché la generazione avviene in blocchi coerenti anziché in una sequenza frammentata.
Perché la velocità è una questione strategica
Aumentare la velocità di generazione non significa solo migliorare l'esperienza utente. Ha implicazioni più ampie:
- Risposte più immediate rendono le interazioni più naturali
- Ridurre i cicli di inferenza aumenta l'efficienza computazionale
- Minori operazioni significano consumi energetici più bassi
- Una maggiore efficienza consente di servire più utenti con le stesse risorse
In un'epoca in cui l'impatto energetico e ambientale dell'AI è sotto crescente attenzione, questi aspetti diventano un vero vantaggio competitivo.
Un esempio pratico
Prompt: "Nel Rinascimento, Leonardo da Vinci è ricordato soprattutto per…"
Con un approccio autoregressivo, il modello genera il testo token dopo token, costruendo lentamente la risposta.
Con un approccio multi-token, può invece produrre direttamente un frammento coerente, ad esempio: "le sue opere d'arte come la Gioconda", con un controllo immediato di coerenza prima dell'integrazione nell'output finale.
Conclusione
La predizione multi-token rappresenta più di una semplice ottimizzazione prestazionale. È un segnale di maturazione dell'ecosistema dei Large Language Model. Dopo anni in cui l'attenzione si è concentrata quasi esclusivamente sulla scala dei modelli, emergono approcci che ripensano il modo in cui questi sistemi operano internamente.
Attraverso tecniche come le maschere di predizione, gli adapter LoRA e i sistemi di controllo, è possibile rendere i modelli più veloci, più efficienti e più sostenibili, senza sacrificare la qualità dell'output e senza dover ricominciare da zero.
È un passo nella direzione di un'AI meno "magica" e più consapevolmente ingegnerizzata. Un'AI che non solo sa parlare bene, ma lo fa in modo sempre più efficiente, controllato e responsabile.