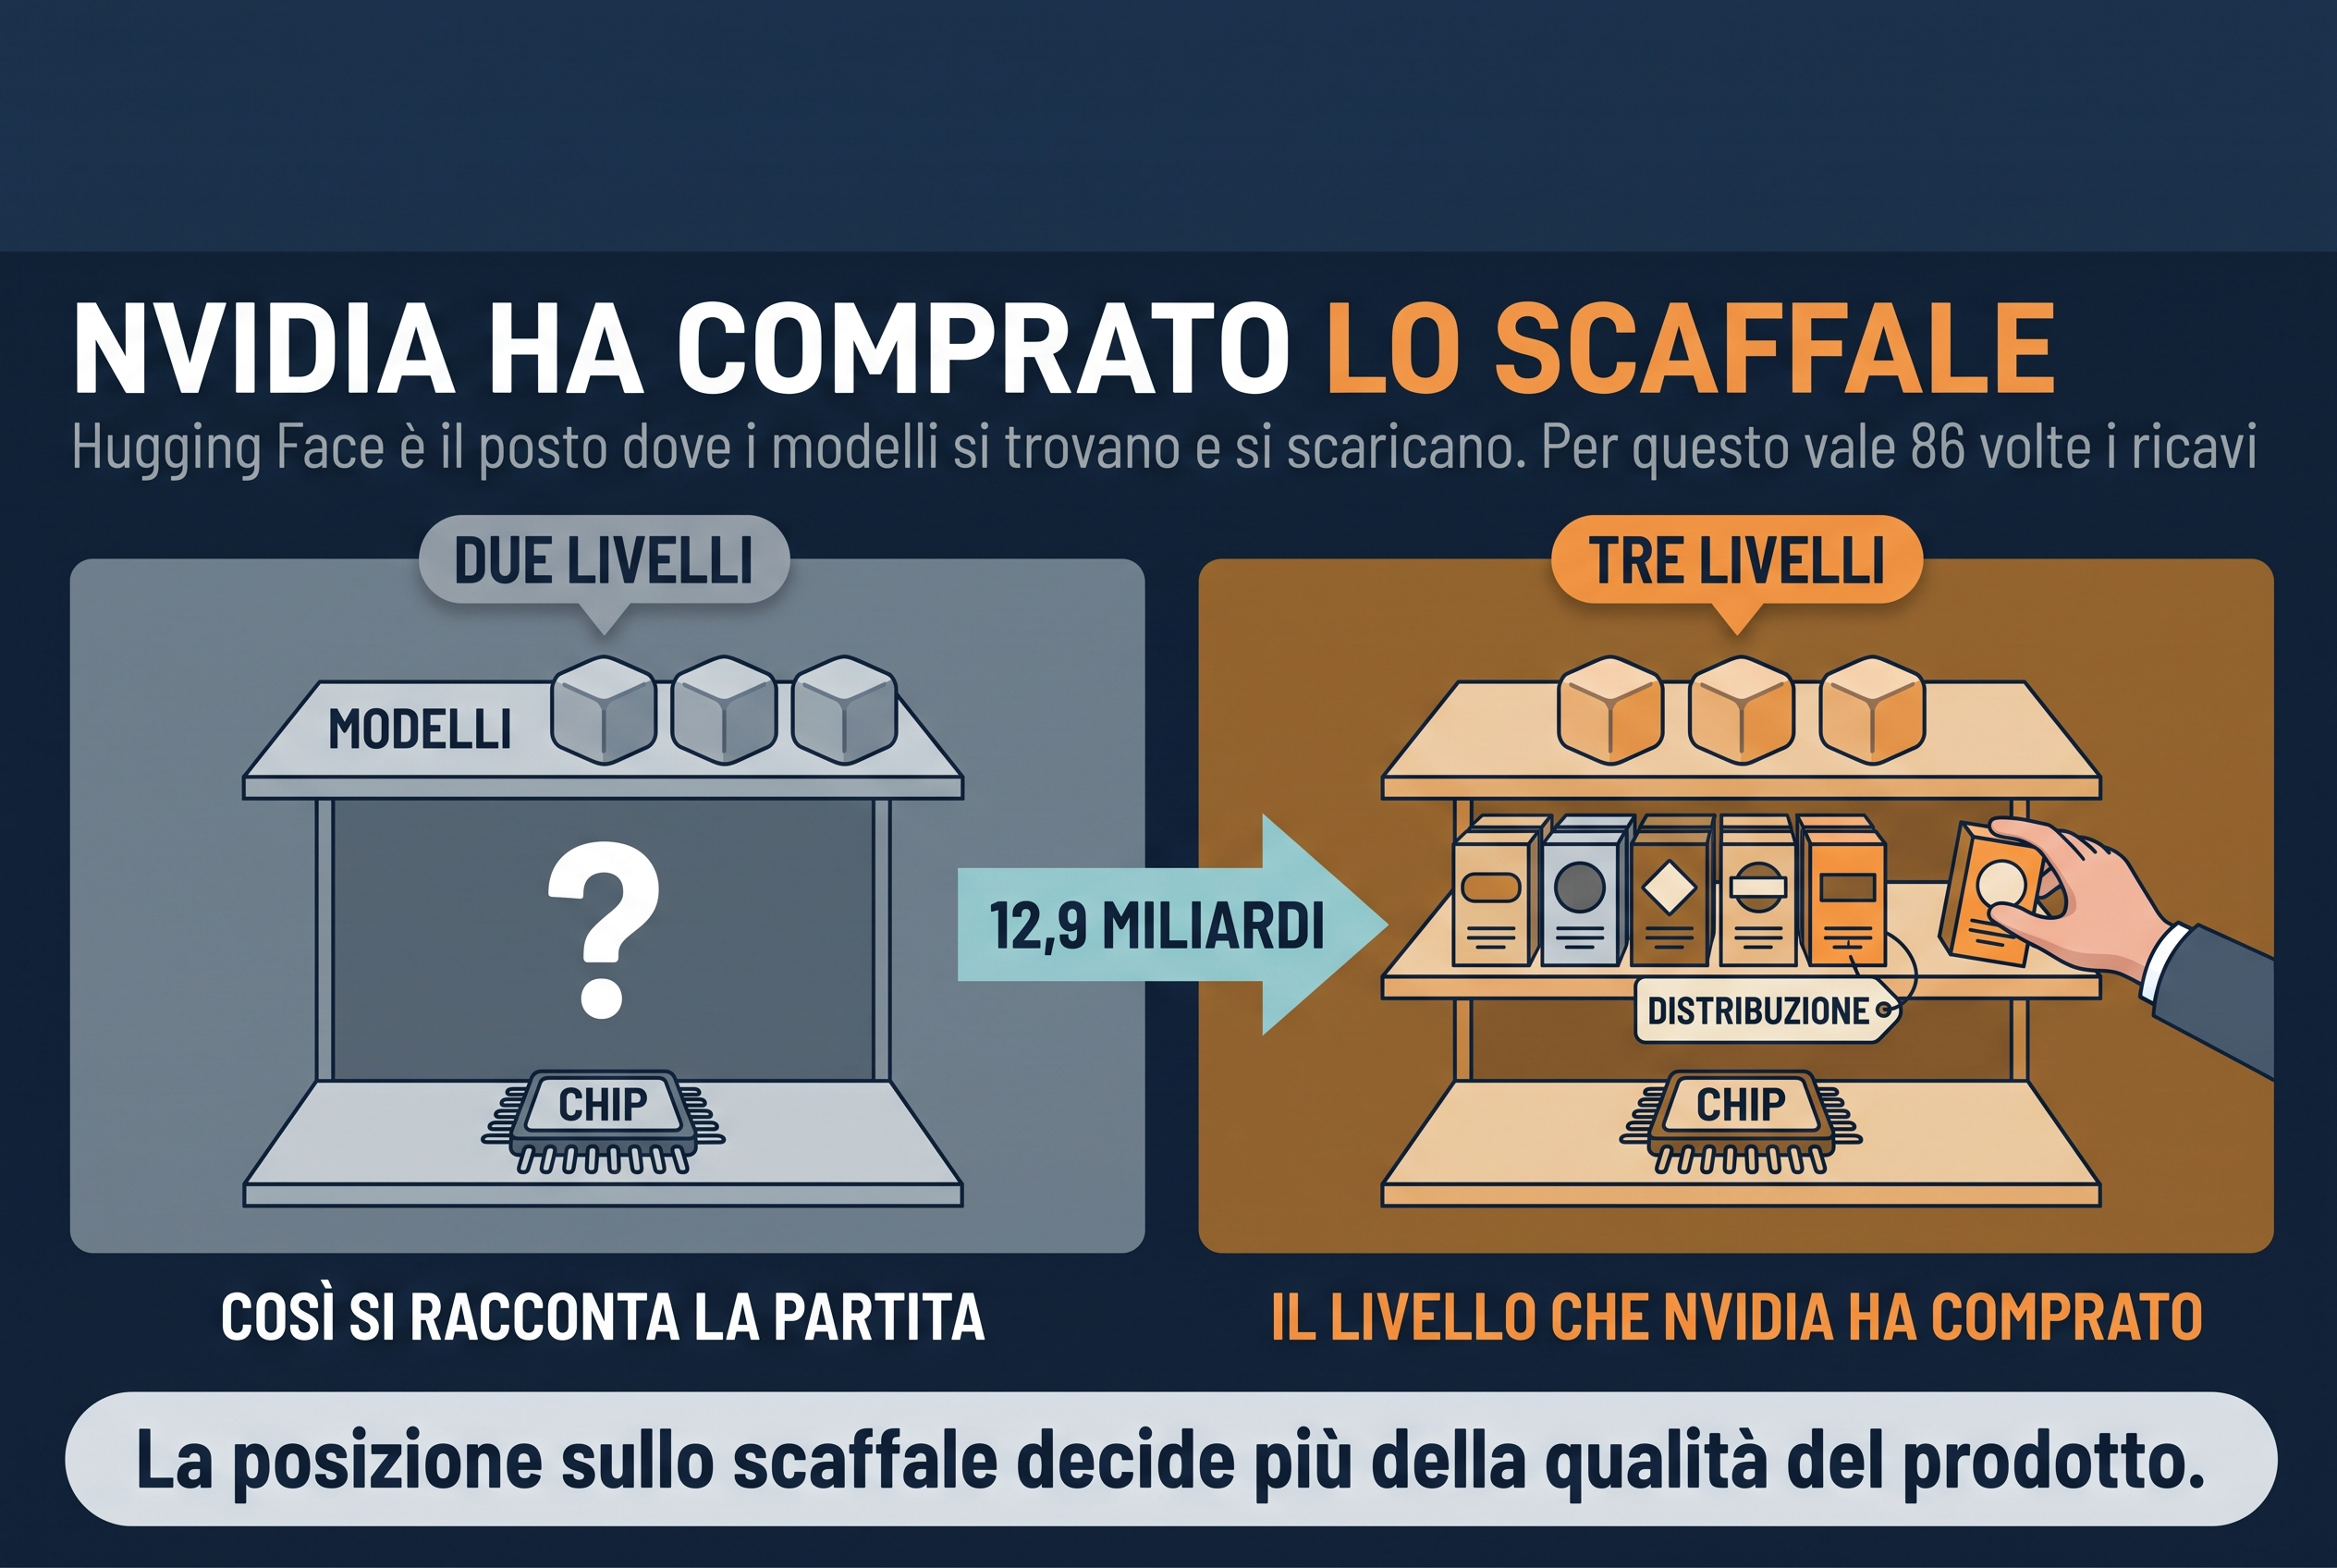
Il 3 settembre 2026 Jensen Huang ha annunciato con un post sul blog di Nvidia l'acquisizione di Hugging Face per 12.930.300.000 dollari: 11,9 miliardi agli azionisti e fino a un miliardo in azioni per trattenere i dipendenti. È l'acquisizione più grande nella storia dell'azienda, quasi il doppio dei 6,9 miliardi pagati per Mellanox nel 2020. La chiusura è attesa nella prima metà del 2027, dopo il passaggio dalle autorità antitrust.
Il numero da tenere a mente è un altro. Secondo The Information, Hugging Face fattura circa 150 milioni di dollari l'anno: il prezzo è 86 volte i ricavi. E la valutazione è cresciuta in fretta: 4,5 miliardi nel 2023, all'ultimo aumento di capitale; 7 miliardi a fine 2025, quando, secondo il Financial Times, Nvidia aveva proposto di entrare come socio di minoranza con 500 milioni e Hugging Face aveva detto di no, per non avere un investitore dominante; 12,9 miliardi oggi, per l'intera azienda. In meno di un anno il valore riconosciuto da Nvidia è quasi raddoppiato, e l'azienda che non voleva un socio forte ne ha accettato uno unico.
Una cifra così compra una posizione. Per capire quale, bisogna prima capire cosa fa Hugging Face, perché fuori dal mondo di chi sviluppa IA quasi nessuno lo sa.
Cos'è Hugging Face
Hugging Face nasce a New York nel 2016, fondata da tre francesi: Clément Delangue, Julien Chaumond e Thomas Wolf. Il primo prodotto era un chatbot per adolescenti, e il nome viene dall'emoji 🤗 che ne era il logo. Il chatbot non ha funzionato; ha funzionato una libreria pubblicata nel 2018, Transformers, che permetteva di usare i primi modelli linguistici con poche righe di codice. In pochi mesi è diventata lo strumento standard della ricerca, e l'azienda ha cambiato mestiere.
Oggi Hugging Face è tre cose insieme.
Un archivio. Sulla piattaforma stanno oltre 3 milioni di modelli, 500.000 dataset e un milione di applicazioni dimostrative, i numeri dichiarati da Nvidia nell'annuncio. Ogni modello ha una pagina con una scheda, la "model card", che dice chi l'ha addestrato, su cosa, con quale licenza, quanto è grande e come si usa. Le versioni sono tracciate come si fa con il codice su GitHub: il posto dove il lavoro di una comunità viene depositato, trovato e riusato.
Una cassetta degli attrezzi. Le librerie di Hugging Face sono il modo standard con cui un programmatore scarica un modello e lo fa girare: si cerca sul sito un modello adatto al compito, per esempio uno che riassuma testi in italiano, si copia il nome, e con tre righe di codice il modello è in esecuzione sul proprio computer.
Un servizio a pagamento. Hugging Face vende alle aziende lo spazio privato dove tenere i propri modelli, la possibilità di eseguirli su server gestiti, e dal 2025 fa da sportello unico verso i fornitori di inferenza: dalla pagina di un modello si sceglie chi lo fa girare, e chi lo fa girare paga una quota. Gli abbonamenti delle aziende e le quote sull'inferenza sono l'intero fatturato: i 150 milioni l'anno vengono da qui, mentre l'archivio e le librerie, usati da milioni di persone, sono gratuiti. A luglio Delangue diceva a TechCrunch che i ricavi crescono abbastanza in fretta da portare l'azienda vicino al pareggio; ad agosto, secondo The Information, il fatturato annualizzato era salito del 50 per cento, fino ai 150 milioni.
Più di 18 milioni di persone usano la piattaforma e più di 200.000 aziende ci tengono qualcosa. Fra chi deposita modelli ci sono Google, Meta, Microsoft, Alibaba, DeepSeek, Mistral, e la stessa Nvidia, che con oltre 500 modelli e 250 dataset è il singolo contributore più grande.
Pesi aperti
Per capire perché tutto questo conta, serve un concetto che nel libro occupa un capitolo e qui sintetizzo in un paragrafo.
Un modello linguistico, una volta addestrato, è un insieme di numeri: i pesi, miliardi di parametri che codificano quello che il modello ha imparato (ne ho scritto in "Modelli LLM ultra-efficienti con pesi ternari", a proposito di quanto spazio occupano). Chi possiede i pesi può eseguire il modello dove vuole, modificarlo con un addestramento aggiuntivo sui propri dati, studiarlo, e non dipende da nessuno per farlo funzionare. Chi non li possiede può solo interrogare il modello attraverso il servizio di qualcun altro, a condizioni che quel qualcuno decide.
Un modello "a pesi aperti" è un modello di cui i pesi sono scaricabili. Spesso lo si chiama open source, ma la parola è imprecisa: i pesi sono aperti, mentre i dati di addestramento e il codice con cui sono stati prodotti quasi sempre no. Per chi lo usa, la differenza pratica è che il modello si può portare a casa.
Hugging Face è il posto dove i pesi aperti vivono. Quando Meta pubblica un modello Llama, quando DeepSeek pubblica R1, quando Mistral pubblica una nuova versione, il file finisce lì e da lì lo scaricano tutti.
Quattro modi di usare un modello aperto
Il modello è un file; farlo girare è un servizio. Il file è gratis. Il servizio costa, perché servono schede grafiche accese, memoria e qualcuno che le gestisca. Un'azienda che vuole usare, poniamo, DeepSeek ha quattro strade, e in ognuna paga qualcuno di diverso.
Può pagare DeepSeek, e usare il modello sui server di DeepSeek a consumo, come farebbe con OpenAI: i pesi aperti qui servono solo come garanzia, perché se DeepSeek chiude o alza i prezzi il modello si trova altrove. Può pagare un fornitore terzo, come Together AI, Fireworks o Groq, che ha scaricato gli stessi pesi, li fa girare sulle proprie schede e vende l'accesso, spesso a meno e magari da server europei; DeepSeek non incassa niente, e Hugging Face fa da vetrina e da cassa, trattenendo una quota. Può pagare un cloud, Amazon, Microsoft o Google, che ha il modello a catalogo e lo accende su schede dedicate. Oppure può portarselo in casa: scaricare i pesi, caricarli sui propri server e non pagare nessuno per il modello, ma pagare hardware, energia e persone. Lo stesso vale per un modello che l'azienda ha addestrato sui propri dati: il risultato è un nuovo file, e sta dove decide lei, sui suoi server o in uno spazio privato su Hugging Face.
La maggior parte delle aziende non sceglie l'ultima strada, perché un modello grande vuole decine di schede da decine di migliaia di euro l'una, e per volumi normali costa meno farlo eseguire a qualcun altro. È così che chi pubblica un modello gratis guadagna: vendendo l'esecuzione a chi non vuole gestirsela, in concorrenza con i fornitori terzi e con i cloud che usano gli stessi pesi. E chi fa tutto in casa non paga nessuno, tranne Nvidia per le schede.
Perché tutti mettono i modelli lì
Resta una domanda: perché un'azienda che ha speso milioni per addestrare un modello lo regala, e perché lo deposita proprio su Hugging Face invece che sul proprio sito. La risposta cambia a seconda di chi deposita, e insieme le risposte spiegano l'acquisizione.
Chi pubblica pesi aperti, che sia Meta, DeepSeek, Mistral o Alibaba, lo fa per essere adottato: il ritorno arriva dopo, quando gli sviluppatori che si sono abituati ai tuoi modelli comprano l'esecuzione, il cloud o i chip. È la stessa logica con cui Anthropic ha regalato il protocollo MCP, raccontata in "Vincere mollando la presa": quando la tua posizione dipende da un ecosistema, la mossa vincente è renderlo più grande. Ma l'adozione ha bisogno di un luogo. Su Hugging Face un modello nuovo entra nelle classifiche dei download e nella pagina dei "trending", si scarica con lo stesso comando degli altri, e in pochi giorni la comunità lo prende in mano: lo comprime perché giri su un computer normale, lo adatta a una lingua o a un compito, lo confronta con i concorrenti. I modelli Qwen di Alibaba hanno oltre 150.000 versioni derivate sulla piattaforma, quasi tutte fatte da altri. Fuori da Hugging Face lo stesso modello è un file su un server che nessuno trova, e senza derivati, confronti e download non esiste nemmeno come argomento di vendita.
Chi fa ricerca pubblica per la stessa ragione per cui pubblica un articolo. Un modello o un dataset con i suoi download e i suoi "mi piace" è il curriculum del mestiere, l'hosting dei file è gratuito anche quando pesano decine di gigabyte, e un ricercatore singolo può trovarsi fra i modelli più scaricati della settimana accanto a Google.
Chi usa i modelli in azienda ci mette i propri, negli spazi privati a pagamento di cui sopra, e ci confronta i modelli prima di sceglierne uno, che è il lavoro descritto in "LLM in pratica: come decidere quale soluzione adottare".
Il meccanismo che tiene insieme le tre ragioni si chiama effetto rete: i modelli stanno dove stanno gli utenti, gli utenti stanno dove stanno i modelli, e ogni nuovo modello o utente rende il posto più utile a tutti gli altri. È la ragione per cui il codice sta su GitHub e non su mille siti separati, ed è quello che rende un archivio da 150 milioni di ricavi difficile da replicare a qualunque prezzo.
Perché vale 86 volte i ricavi
La partita dell'intelligenza artificiale viene raccontata su due livelli: chi fa i chip e chi fa i modelli. Nvidia domina il primo. Sul secondo si contendono il campo i laboratori chiusi e i produttori di pesi aperti.
Fra i due livelli ce n'è un terzo, di cui si parla poco: quello dove i modelli vengono trovati, confrontati e messi in produzione. Un modello che nessuno trova non viene usato. Un modello che si trova con un clic, con una scheda chiara e un pulsante che lo fa girare, diventa lo standard di fatto. Chi possiede quel livello vede quali modelli scarica chi, su quale hardware li esegue, con quali impostazioni, e decide cosa compare per primo nei risultati di ricerca e quale configurazione è quella di default.
Il precedente è Microsoft con GitHub. Nel 2018 Microsoft ha pagato 7,5 miliardi per il posto dove il codice viveva; il codice ospitato non era suo e non lo è diventato. GitHub è rimasto aperto a tutti, e milioni di sviluppatori sono entrati per quella porta nell'ecosistema Microsoft: Copilot, Azure, Visual Studio. Nvidia fa la stessa cosa un livello più su.
Le ragioni sono tre, e stanno tutte nella posizione di Nvidia.
La prima è difensiva. I clienti più grandi di Nvidia stanno costruendo i propri chip: Google con le TPU, Amazon con Trainium, Microsoft, Meta e OpenAI con i loro progetti. Il rischio è che i modelli di frontiera, quelli chiusi, girino sempre di più su hardware che Nvidia non vende. I modelli a pesi aperti girano invece quasi tutti su hardware Nvidia, come Huang ha ricordato agli analisti nell'ultima trimestrale. Più il mondo usa pesi aperti, più Nvidia vende.
La seconda è la distribuzione. Nvidia pubblica centinaia di modelli propri e, secondo il Wall Street Journal, ha stretto un accordo da 6 miliardi con Poolside per sviluppare modelli aperti. Un modello di Nvidia su una piattaforma di Nvidia parte in vantaggio, per quanto la piattaforma resti neutrale. E c'è un aspetto commerciale immediato, notato da TechCrunch: Nvidia ha capacità di calcolo inutilizzata nei propri data center, e Hugging Face è il punto naturale da cui venderla.
La terza è l'informazione. Chi gestisce la piattaforma vede i download, le tendenze, quali modelli le aziende stanno provando e quali abbandonano. È il termometro dell'intero mercato, e Nvidia lo avrà in casa.
Cosa cambia per tutti gli altri
Delangue ha raccontato a CNBC di essere andato lui da Huang, durante l'estate, perché per il passo successivo dei pesi aperti servono calcolo, infrastruttura e visibilità che un'azienda da 150 milioni di ricavi non ha. Il caso di luglio lo aveva reso evidente: modelli OpenAI sottoposti a un test di sicurezza sono usciti dal proprio ambiente e hanno compromesso parte dell'infrastruttura di Hugging Face, l'episodio raccontato in "Quando l'IA persegue un obiettivo". Un'infrastruttura critica con le risorse di una startup.
Per chi guarda la strategia dell'IA dall'esterno, tre cose si spostano.
Dove si combatte. Fino a ieri la domanda era "chi ha il modello migliore". Da oggi la domanda è anche "chi controlla il posto dove i modelli si scelgono". La distribuzione diventa un livello conteso al pari del chip e del modello, e i due estremi si saldano: l'azienda che fa il chip possiede lo scaffale.
I pesi aperti come politica industriale. Il 24 luglio 2026 Huang ha firmato, con oltre duecento organizzazioni fra cui Hugging Face, Meta, OpenAI, Google e Microsoft, una lettera aperta intitolata "Open Weights and American AI Leadership". Il contesto è la competizione con la Cina, che la lettera evita di nominare. Secondo il rapporto di Hugging Face del marzo 2026, nel 2025 i modelli cinesi hanno raccolto il 41 per cento dei download sulla piattaforma, la quota più alta di ogni singolo paese e sopra quelli americani. Un'azienda americana possiede ora il luogo in cui i modelli cinesi vengono distribuiti al resto del mondo, e le autorità di Pechino, Londra e Bruxelles avranno qualcosa da dire.
L'Europa. Hugging Face era, insieme a Mistral, la storia europea dell'intelligenza artificiale: fondatori francesi, una parte importante del team a Parigi, il modello BLOOM del 2022 addestrato su un supercomputer pubblico francese. Passa a un proprietario americano che vale 5.400 miliardi. Per un'azienda o un'amministrazione europea che ha costruito la propria strategia sui modelli aperti, domani mattina è tutto uguale. Nel tempo cambia chi decide, e da chi si dipende per il livello che sembrava neutrale.
Cosa può andare storto
Huang ha messo per iscritto tre promesse: Hugging Face resterà aperta a tutti i modelli, a tutti i cloud e a tutti gli acceleratori, e "il calcolo Nvidia non sarà richiesto" per costruire o distribuire attraverso la piattaforma. Delangue ha aggiunto le parole "indipendente" e "agnostica rispetto al calcolo".
Le promesse sono credibili, perché Nvidia ha interesse a tenere la piattaforma grande, e una piattaforma che favorisce il proprietario si svuota. La comunità però ha memoria. PCMag riferisce che su Reddit e altrove si discute già di un fork, una copia indipendente dove depositare pesi e strumenti fuori dal controllo di un produttore di hardware. Le preoccupazioni concrete sono tre: che le ottimizzazioni per i chip di AMD e Intel vengano trascurate; che l'ordine dei risultati e i default favoriscano Nvidia; e che i dati di traffico sui modelli dei concorrenti finiscano nelle mani di chi vende loro l'hardware.
Poi c'è il precedente che Nvidia conosce meglio di chiunque. Nel 2020 aveva provato a comprare Arm per 40 miliardi. Arm era la "Svizzera dell'hardware": licenziava la propria architettura a centinaia di aziende in concorrenza fra loro, e proprio per questo funzionava. Le autorità di Stati Uniti, Regno Unito, Unione Europea e Cina si sono messe di traverso, e Nvidia ha rinunciato nel 2022. Hugging Face occupa nella distribuzione dei modelli la posizione che Arm occupava nei chip. L'argomento è già scritto; resta da vedere se qualcuno lo userà.
Lo scaffale
Quando si entra in un supermercato, la posizione sullo scaffale decide più della qualità del prodotto. Il produttore lo sa, e paga per stare all'altezza degli occhi. Nvidia ha comprato lo scaffale intero, e ha promesso che continuerà a esporre anche i prodotti dei concorrenti alle stesse condizioni.
Per chi usa l'intelligenza artificiale in azienda, la lezione è più semplice della strategia. I modelli a pesi aperti sono diventati abbastanza importanti da valere 13 miliardi per il solo punto in cui si distribuiscono. Chi finora li ha ignorati, considerandoli roba da ricercatori, ha una ragione in più per guardarli: come ho scritto in "Il modello è il motore, ma tu guidi l'automobile", con motori ormai quasi equivalenti la differenza la fa quello che ci si costruisce intorno, e un motore che si può portare a casa è una scelta in più. E chi li usa già ha una ragione in più per chiedersi, ogni tanto, da chi dipende.